VQ-VAE와 VQ-GAN
📄 관련 논문: [NeurIPS 2017] Neural Discrete Representation Learning
📄 관련 논문: [CVPR 2021] Taming Transformers for High-Resolution Image Synthesis
VQ (Vector Quantization)는 연속적인 벡터를 이산적인 코드로 변환하는 과정이다.
VQ-VAE
일반적인 VAE는 Latent Space를 연속적인 확률 분포로 모델링한다.
하지만 디코더의 표현력이 충분히 높을 경우, 사후 붕괴 (Posterior Collapse) 문제가 발생할 수 있다.
VQ-VAE는 Latent Space를 이산적으로 표현함으로써 이러한 한계를 완화하였다.
Posterior Collapse란?
일반적인 VAE는 다음의 손실 함수를 최소화한다.
\[L_{\text{VAE}}=L_{\text{recon}}+\text{KL}(q(z\mid x) \parallel p(z))\]여기서 KL 항은 인코더의 사후 분포 $q(z\mid x)$를 사전 분포 $p(z)$에 가깝게 끌어당기는 정규화 역할을 한다.
하지만 디코더가 너무 강력해서 Latent Variable $z$ 없이도 데이터를 잘 복원할 수 있다면, 모델은 KL 항을 줄이는 가장 쉬운 방법으로 $q(z\mid x)\approx p(z)$를 만들어 버린다.
결과적으로 인코더는 입력에 무관한 Latent Variable을 출력하게 되고, $z$는 $x$에 대한 정보를 담지 않는 무의미한 변수가 된다.
이러한 현상을 Posterior Collapse라 부른다.반면, VQ-VAE에서는 $q(z\mid x)$가 가우시안이 아니라 One-hot 분포이다.
\[q(z=k\mid x)=\begin{cases}1&k=\arg\min_j\lVert z_e(x)-e_j\rVert_2\\0&\text{otherwise}\end{cases}\]또한 사전 분포 $p(z)$를 $K$개의 코드에 대한 균등 분포로 가정한다.
\[\text{KL}(q(z\mid x) \parallel p(z))=1⋅\log\frac{1}{1/K}=\log K\]
이때 KL을 직접 계산하면, 다음과 같이 상수가 된다.즉, 인코더 파라미터에 대한 KL 항의 미분값이 0이므로, KL 항이 사후 분포를 사전 분포 쪽으로 끌어당기는 그래디언트를 만들지 않는다.
이러한 특성으로 인해 VQ-VAE에서는 Posterior Collapse 현상이 발생하지 않는다.
모델 구조
이러한 이산화를 위해 VQ-VAE는 코드북(Codebook)이라는 학습 가능한 벡터들의 집합 ${e_1, e_2, …, e_K}$를 사용한다.
코드북은 잠재 공간을 이산화하는 사전 역할을 하며, 인코더의 출력은 항상 이 코드북 안의 벡터 중 하나로 매핑된다.
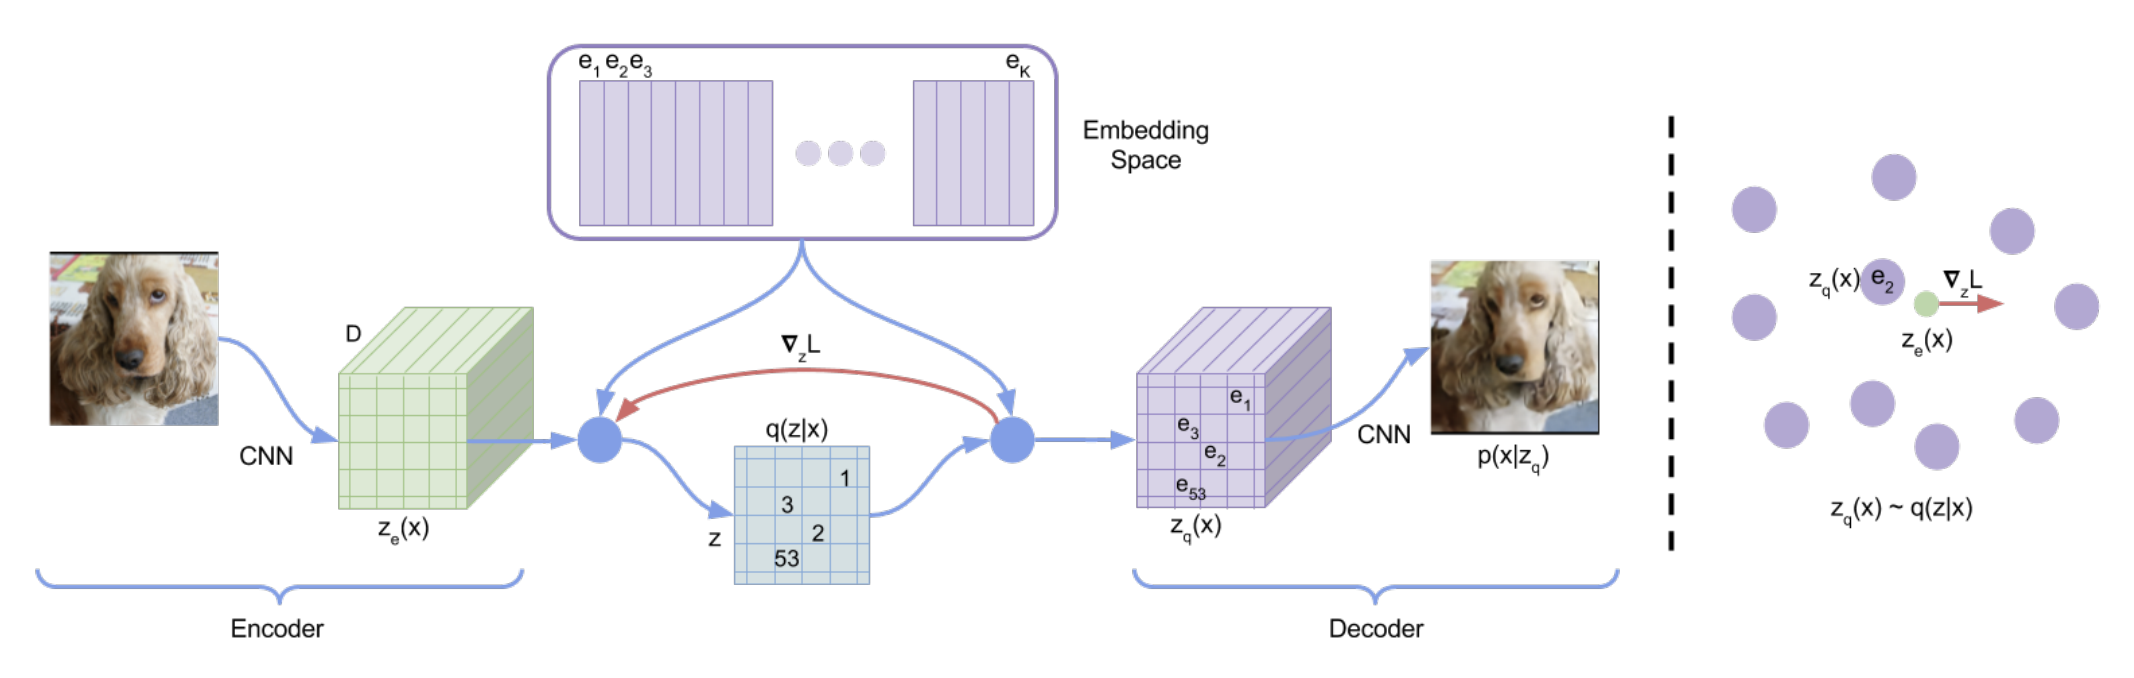
전체 과정은 다음과 같다.
- 입력 이미지 $x$가 인코더를 통과하여 연속적인 잠재 벡터 $z_e(x)$로 변환된다.
$z_e(x)$는 코드북의 벡터들 중 L2 거리가 가장 가까운 벡터 $e_k$로 대체된다. (Quantization)
\[z_q(x) = e_k,\quad\text{where } k = \text{argmin}_j \lVert z_e(x) - e_j \rVert_2 \tag{1}\]- 디코더는 양자화된 벡터 $z_q(x)$를 입력으로 받아 원본 이미지 $x$를 재구성한다.
STE (Straight-Through Estimator)
이때 2번의 양자화 단계에서 $\arg\min$ 연산은 미분이 불가능하므로, 역전파 과정에서 디코더로부터 인코더로 기울기가 전달되지 못하는 문제점이 발생한다.
이를 해결하기 위해 VQ-VAE는 STE 기법을 사용한다.
STE는 디코더 입력 $z_q(x)$에서 계산된 기울기를 그대로 복사하여 인코더 출력 $z_e(x)$로 직접 전달한다.
즉, 역전파 시에 양자화 연산이 마치 항등 함수인 것처럼 취급된다.
이를 통해 인코더는 그래디언트를 정상적으로 받아 학습될 수 있다.
Training Objective
VQ-VAE의 손실 함수는 다음과 같이 3가지 항으로 구성된다.
\[L = -\log p(x\mid z_q(x)) + \lVert \text{sg}[z_e(x)] - e \rVert_2^2 + \beta \lVert z_e(x) - \text{sg}[e] \rVert_2^2 \tag{2}\]위 수식에서 $\text{sg}$는 Stop-Gradient 연산자로, 순전파에서는 입력을 그대로 통과시키지만 역전파 시 그래디언트 흐름을 차단하는 역할을 한다.
이를 통해 하나의 손실 함수 안에서 인코더와 코드북을 분리하여 업데이트할 수 있다.
- $-\log p(x\mid z_q(x))$ (Reconstruction Loss): 원본 이미지와 디코더가 복원한 이미지 간의 차이로, 일반적인 복원 오차에 해당한다.
- $\lVert \text{sg}[z_e(x)] - e \rVert_2^2$ (Codebook Loss): 인코더 출력을 고정시킨 채, 코드북 벡터 $e$가 인코더 출력에 가까워지도록 업데이트한다. 코드북이 실제 데이터 분포에 적응하도록 만드는 항이다.
- $\beta \lVert z_e(x) - \text{sg}[e] \rVert_2^2$ (Commitment Loss): 코드북을 고정시키고, 인코더 출력이 선택된 코드북 벡터에서 너무 멀어지지 않도록 강제한다. 인코더의 출력이 여러 코드북 벡터들 사이에서 진동하지 않고 특정 벡터에 Commit하도록 유도하는 역할을 한다.
디코더의 출력 분포를 가우시안 $\mathcal{N}(\hat{x}, \sigma^2 I)$으로 가정하면, Reconstruction Loss는 다음과 같이 L2 Loss로 치환될 수 있다.
\[−\log p(x\mid z_q(x))=\frac{1}{2\sigma^2}\lVert x−\hat{x}\rVert_2^2+\text{const} \tag{3}\]VQ-GAN
VQ-VAE는 이산적인 Latent Representation을 학습하는 틀을 제공했지만, 복원된 이미지가 흐릿해진다는 문제점이 있다.
Reconstruction Loss로 사용되는 픽셀 단위의 L2 오차가 디코더가 가능한 출력들의 평균에 가까운 값을 내도록 유도하기 때문에 고주파 디테일이 소실되는 경향이 있고, 압축률 (다운샘플링 비율)을 키울수록 이 문제는 더 심해진다.
VQ-GAN은 이를 해결하기 위해 VQ-VAE의 Reconstruction Loss를 Perceptual Loss + Adversarial Loss의 조합으로 대체하였고, 이를 통해 강한 압축률에서도 시각적으로 풍부한 복원이 가능해졌다.
모델 구조
VQ-GAN의 인코더-코드북-디코더 구조는 VQ-VAE와 동일하며, $\arg\min$ 연산의 미분 불가능 문제 역시 VQ-VAE와 마찬가지로 STE로 처리된다.
\[\hat{x}= G(z_\vq) = G (\vq(E(x))) \tag{4}\]위 수식에서 $E$는 인코더, $G$는 디코더, $\vq$는 양자화 연산을 의미한다.
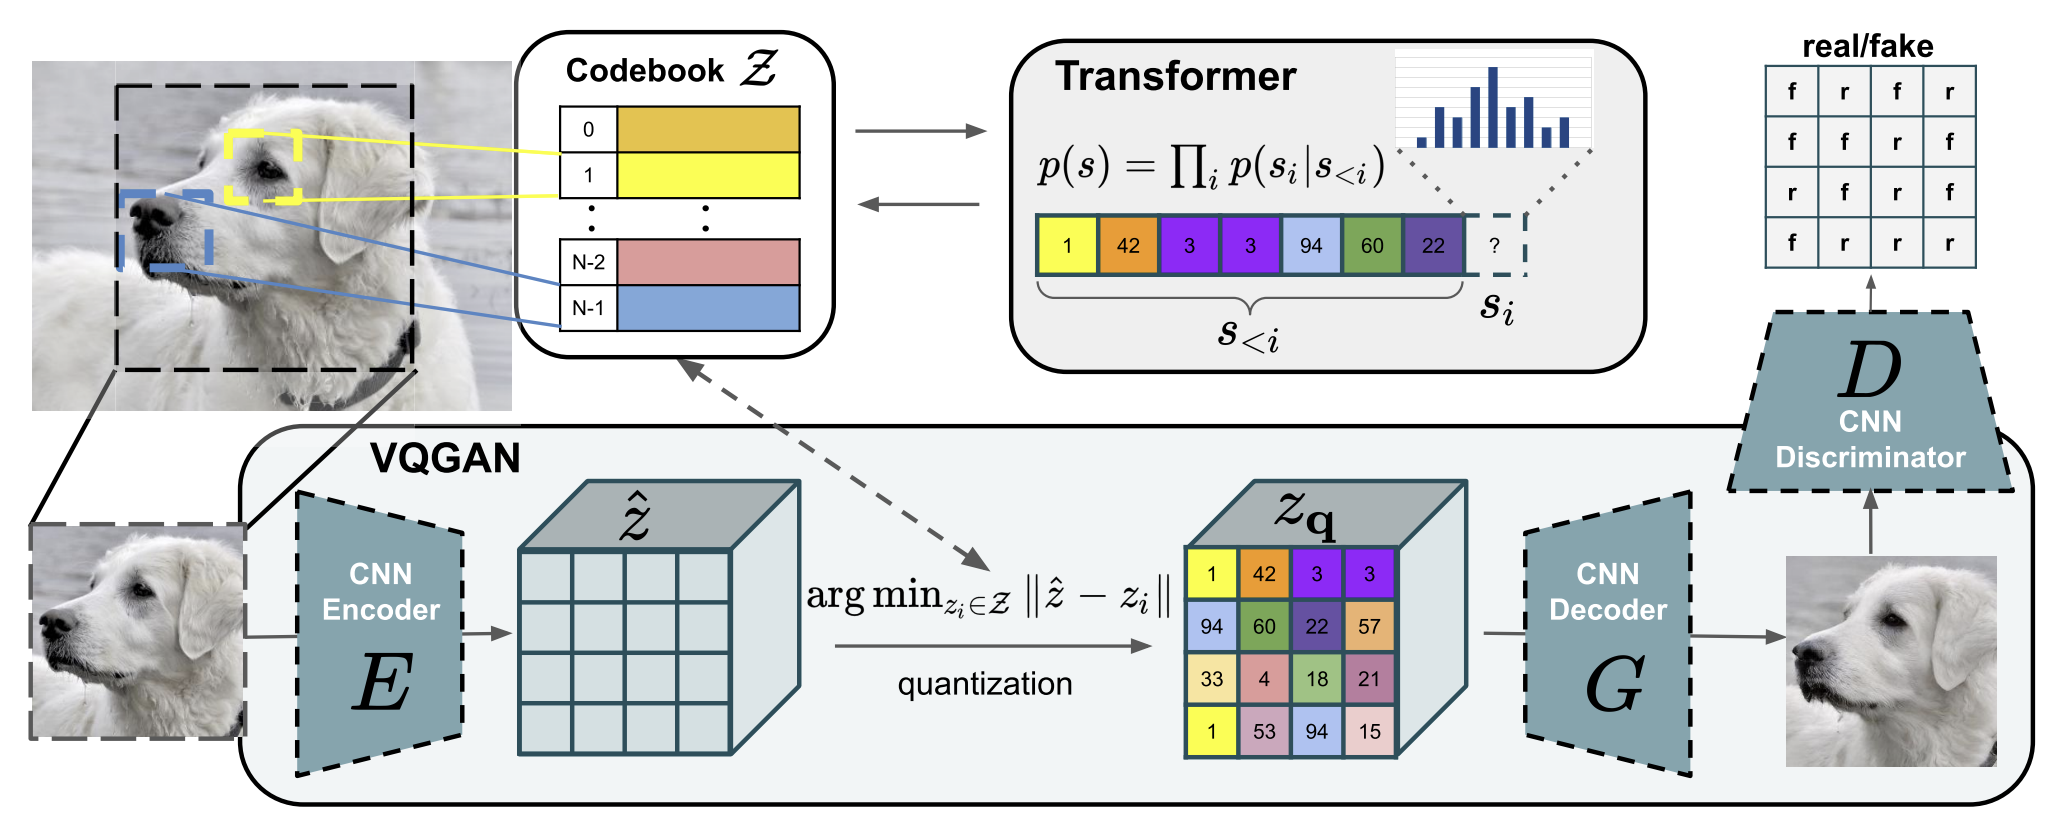
VQ-VAE와 다른점은 디코더의 출력 $\hat{x}$가 단순히 픽셀 오차로 평가되지 않고, Perceptual Network와 Patch-based Discriminator를 함께 거치며 평가된다.
Training Objective
VQ-GAN의 전체 학습 목표는 다음과 같다.
\[\mathcal{Q}^* = \arg\min_{E, G, \mathcal{Z}} \max_{D} \mathbb{E}_{x \sim p(x)} \Big[ \mathcal{L}_{\text{VQ}}(E, G, \mathcal{Z}) + \lambda\, \mathcal{L}_{\text{GAN}}(\{E, G, \mathcal{Z}\}, D) \Big] \tag{5}\]$E, G, \mathcal{Z}$는 손실을 최소화하는 방향으로, Discriminator $D$는 최대화하는 방향으로 적대적으로 함께 학습된다.
VQ Loss
$\mathcal{L}_{\text{VQ}}$는 VQ-VAE로부터 그대로 가져온 항이다.
\[\mathcal{L}_{\text{VQ}}(E, G, \mathcal{Z}) = \lVert x - \hat{x} \rVert^2 + \lVert \text{sg}[E(x)] - z_{\vq} \rVert_2^2 + \lVert \text{sg}[z_{\vq}] - E(x) \rVert_2^2 \tag{6}\]첫 항 $\mathcal{L}_{\text{rec}}$는 VQ-VAE에서는 픽셀 L2 Loss $\lVert x - \hat{x} \rVert^2$였지만, VQ-GAN에서는 이를 Perceptual Loss로 대체한다. (논문에서 구체적인 수식 형태는 명시하지 않음)
Adversarial Loss
Adversarial Loss는 표준 GAN의 형태를 따른다.
\[\mathcal{L}_{\text{GAN}}(\{E, G, \mathcal{Z}\}, D) = \left[ \log D(x) + \log(1 - D(\hat{x})) \right] \tag{7}\]$D$는 실제 이미지 $x$에는 높은 점수를, 재구성된 $\hat{x}$에는 낮은 점수를 부여하도록 학습되고, $E, G, \mathcal{Z}$는 그 반대 방향으로 학습된다.
Adaptive Weighting
Adversarial Loss가 학습 초기에 지나치게 크면 모델이 발산하고, 너무 작으면 다시 픽셀 평균에 가까운 흐릿한 출력으로 회귀한다.
VQ-GAN은 Reconstruction Loss와 Adversarial Loss의 균형을 고정 하이퍼파라미터로 두지 않고, 가중치 $\lambda$를 동적으로 결정한다.
\[\lambda = \frac{\nabla_{G_L}[L_{\text{rec}}]}{\nabla_{G_L}[L_{\text{adv}}] + \delta} \tag{8}\]