LDM (Latent Diffusion Model)
📄 관련 논문: [CVPR 2022] High-Resolution Image Synthesis with Latent Diffusion Models
📄 관련 논문: [ICLR 2024] SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis
LDM은 기존 디퓨전 과정을 latent 공간에서 수행하도록 설계된 모델 구조로, Stability AI의 지원을 받아 대규모로 학습되었기에 Stable Diffusion (SD)이라고도 불린다.
SD에는 여러 버전이 있으며, 그 중 많이 사용되는 버전인 SD 1.5와 SDXL의 스펙은 다음과 같다.
| SD 1.5 | SDXL | |
|---|---|---|
| U-Net 파라미터 수 | 860M | 2.6B |
| 텍스트 인코더 | OpenAI CLIP ViT-L/14 | OpenCLIP ViT-bigG + OpenAI CLIP ViT-L/14 |
| Context 차원 | 768 | 2048 (1280 + 768) |
| 학습 이미지 해상도 | 512 x 512 | 1024 x 1024 |
| Latent Space 차원 | 64 x 64 x 4 | 128 x 128 x 4 |
Stable Diffusion 1.5 (SD 1.5) 모델 구조
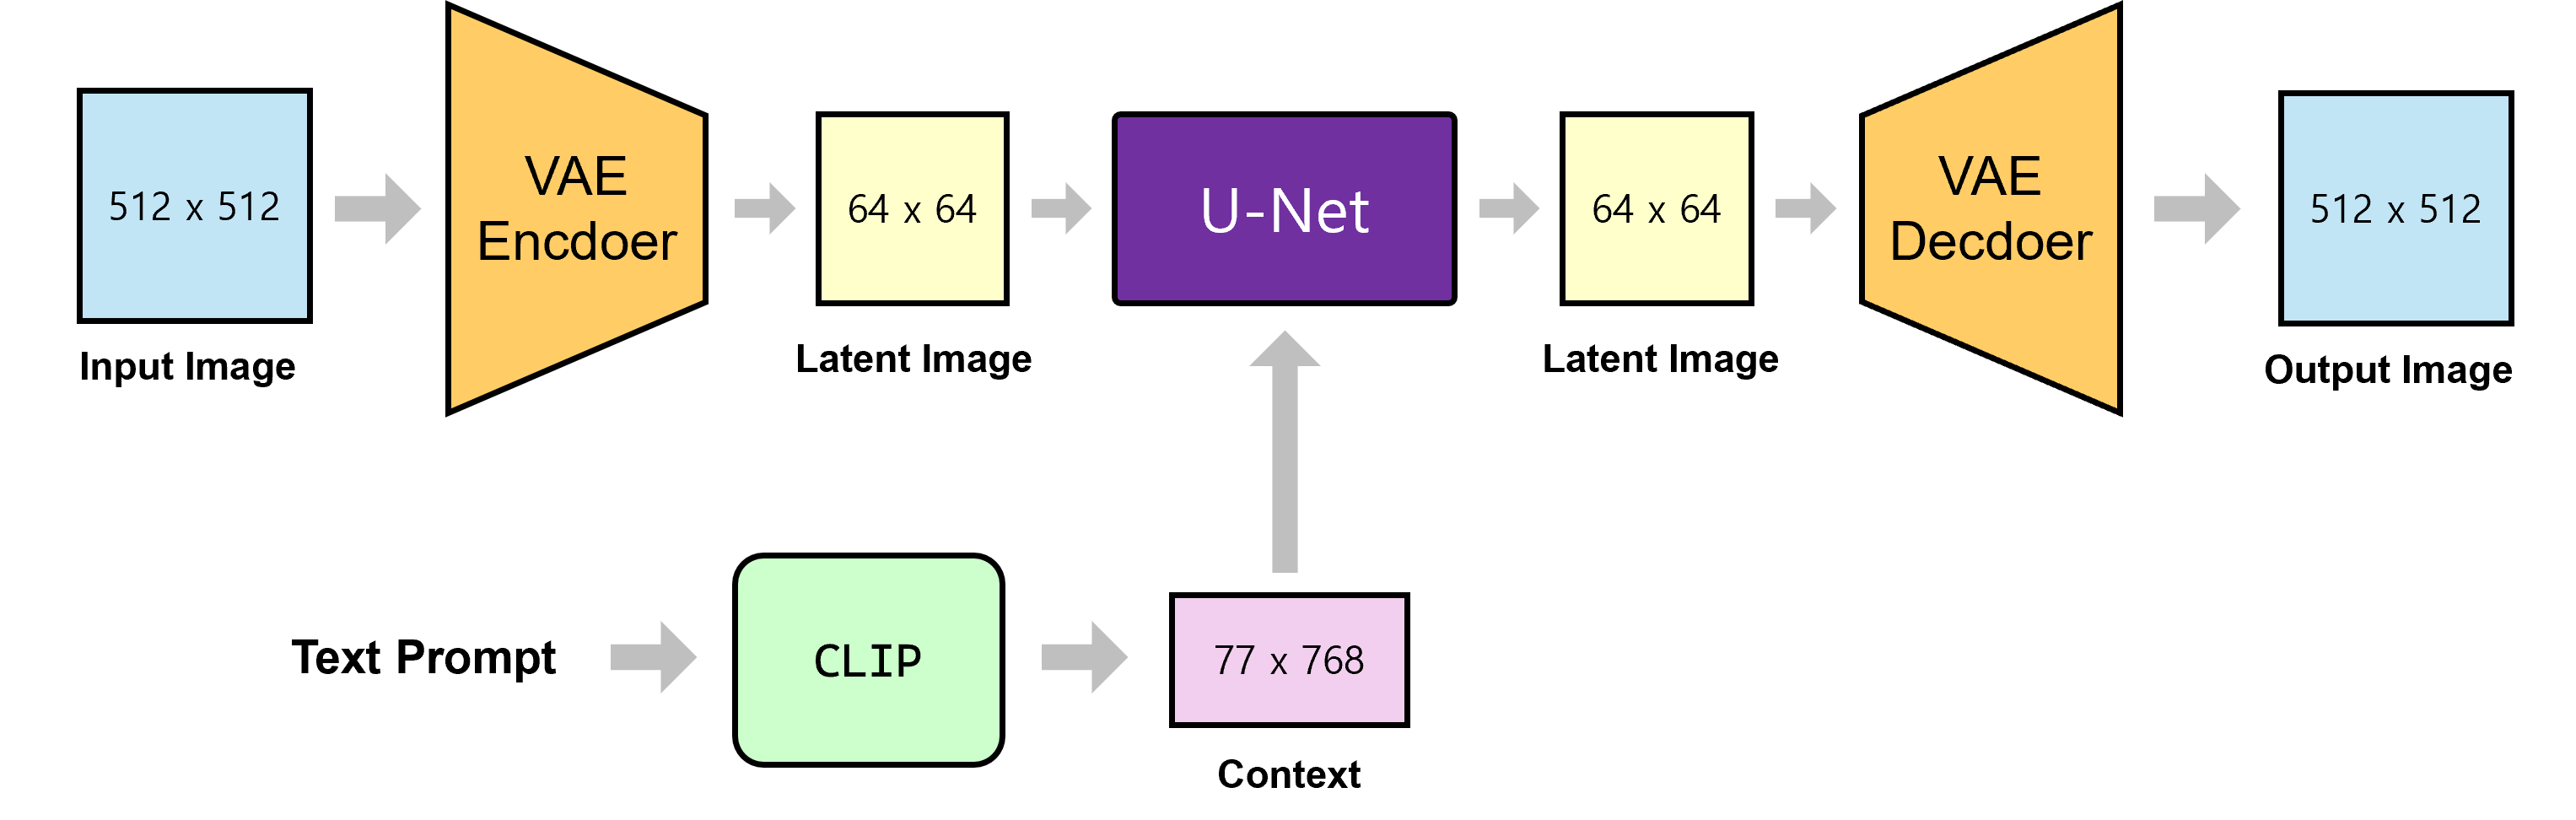
SD 1.5의 전체 구조는 아래와 같다.
VAE Encoder를 통해 입력 이미지를 latent 공간으로 보낸 뒤에, 디퓨전 과정을 진행한다.
U-Net 모델 구조
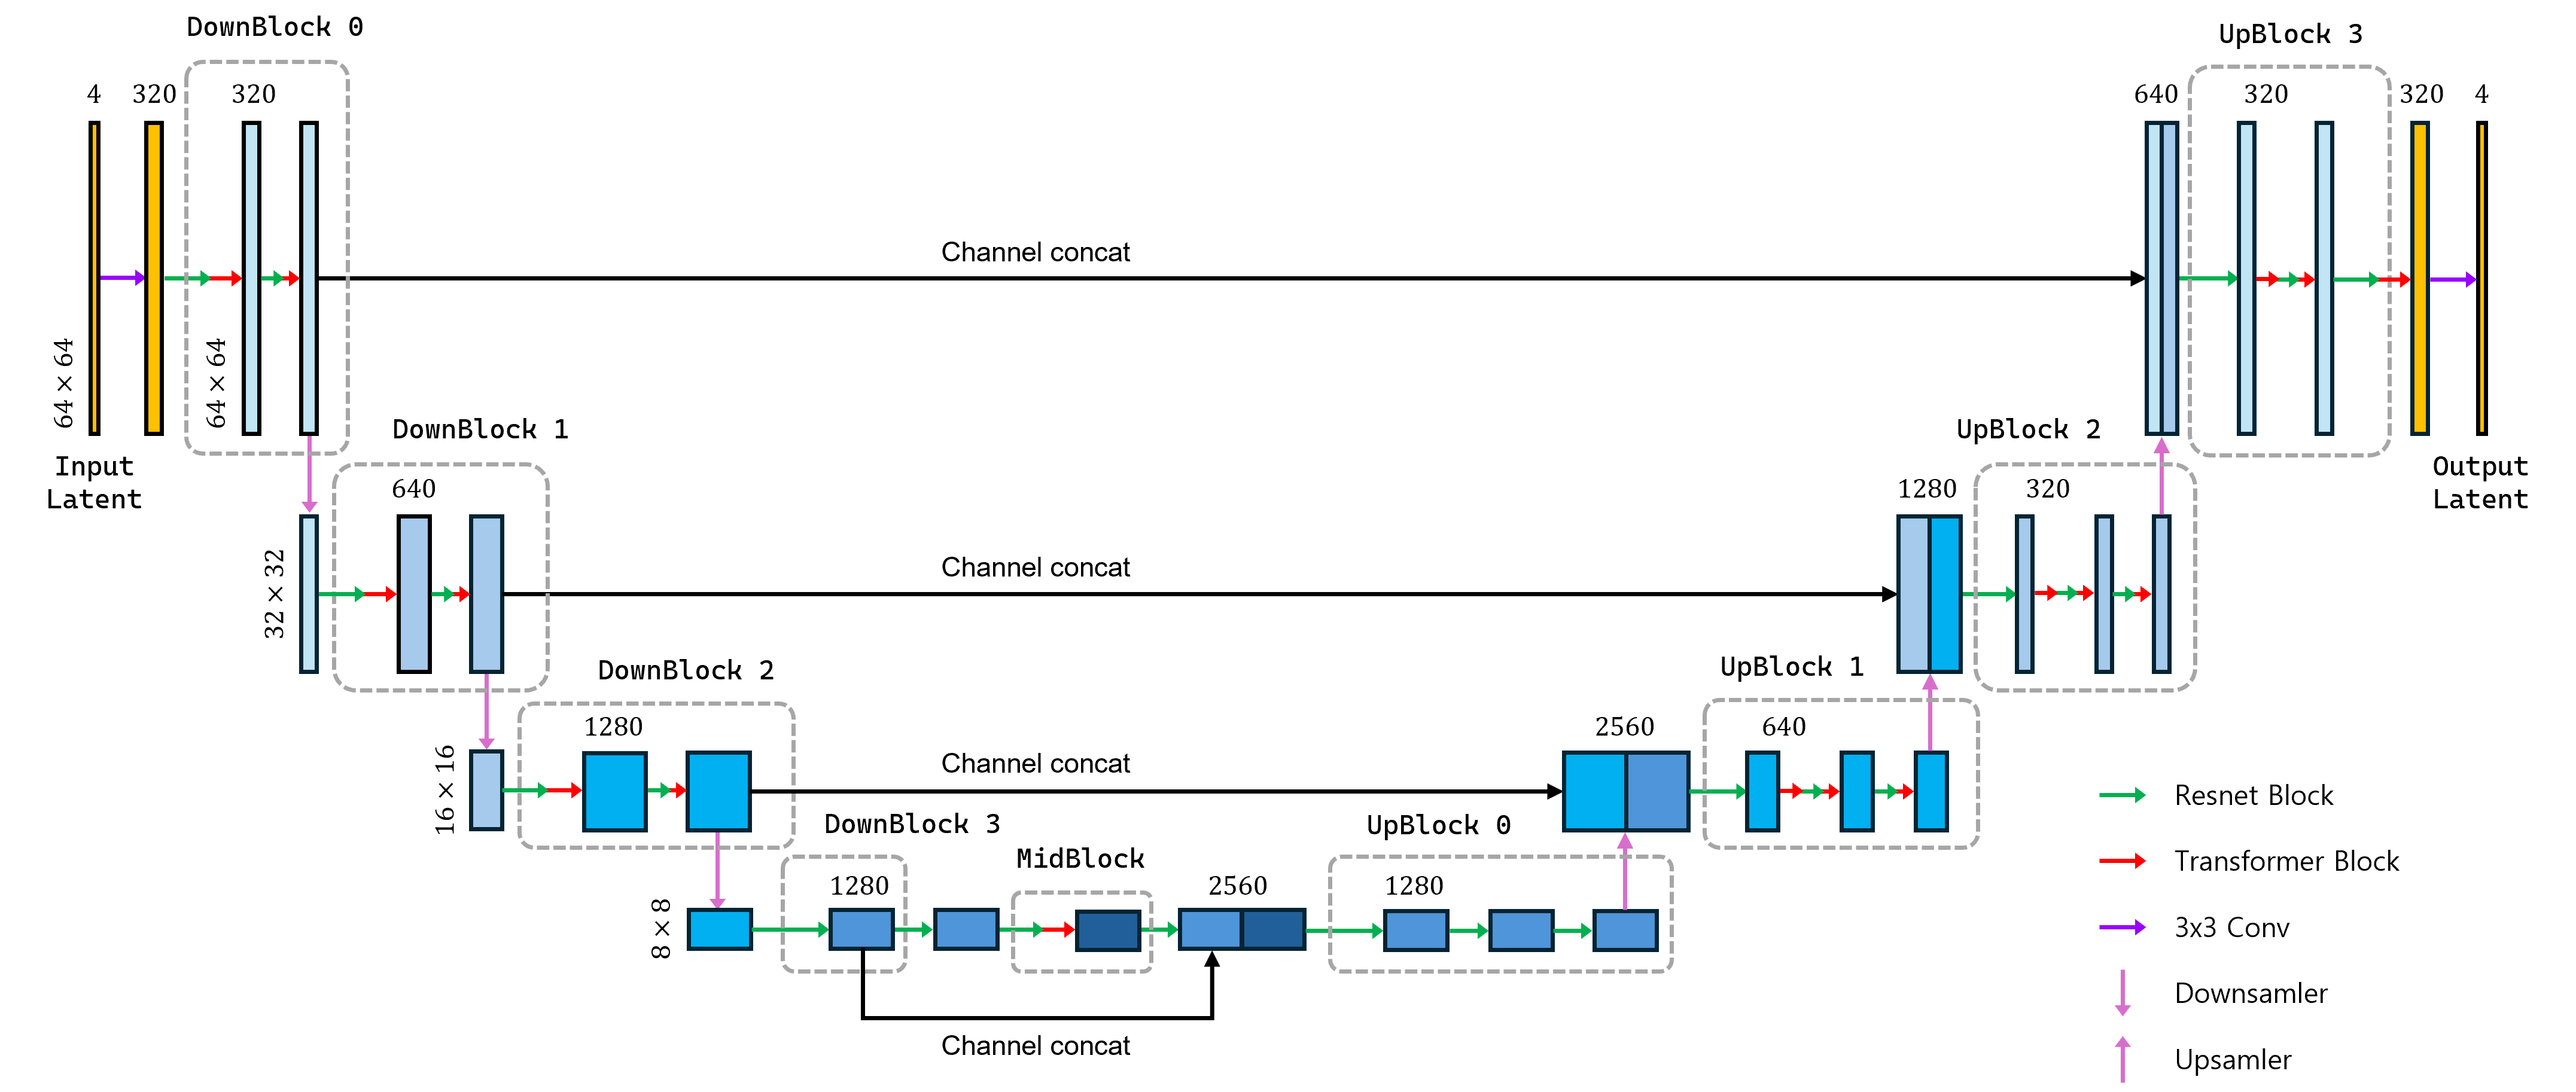
U-Net의 구조는 아래와 같다.
- 초록색 화살표마다 Noise Timestep이 덧셈 형태로 주입된다.
- 빨간색 화살표마다 Context가 Cross-Attention을 통해 조건으로 주입된다.
Resnet Block
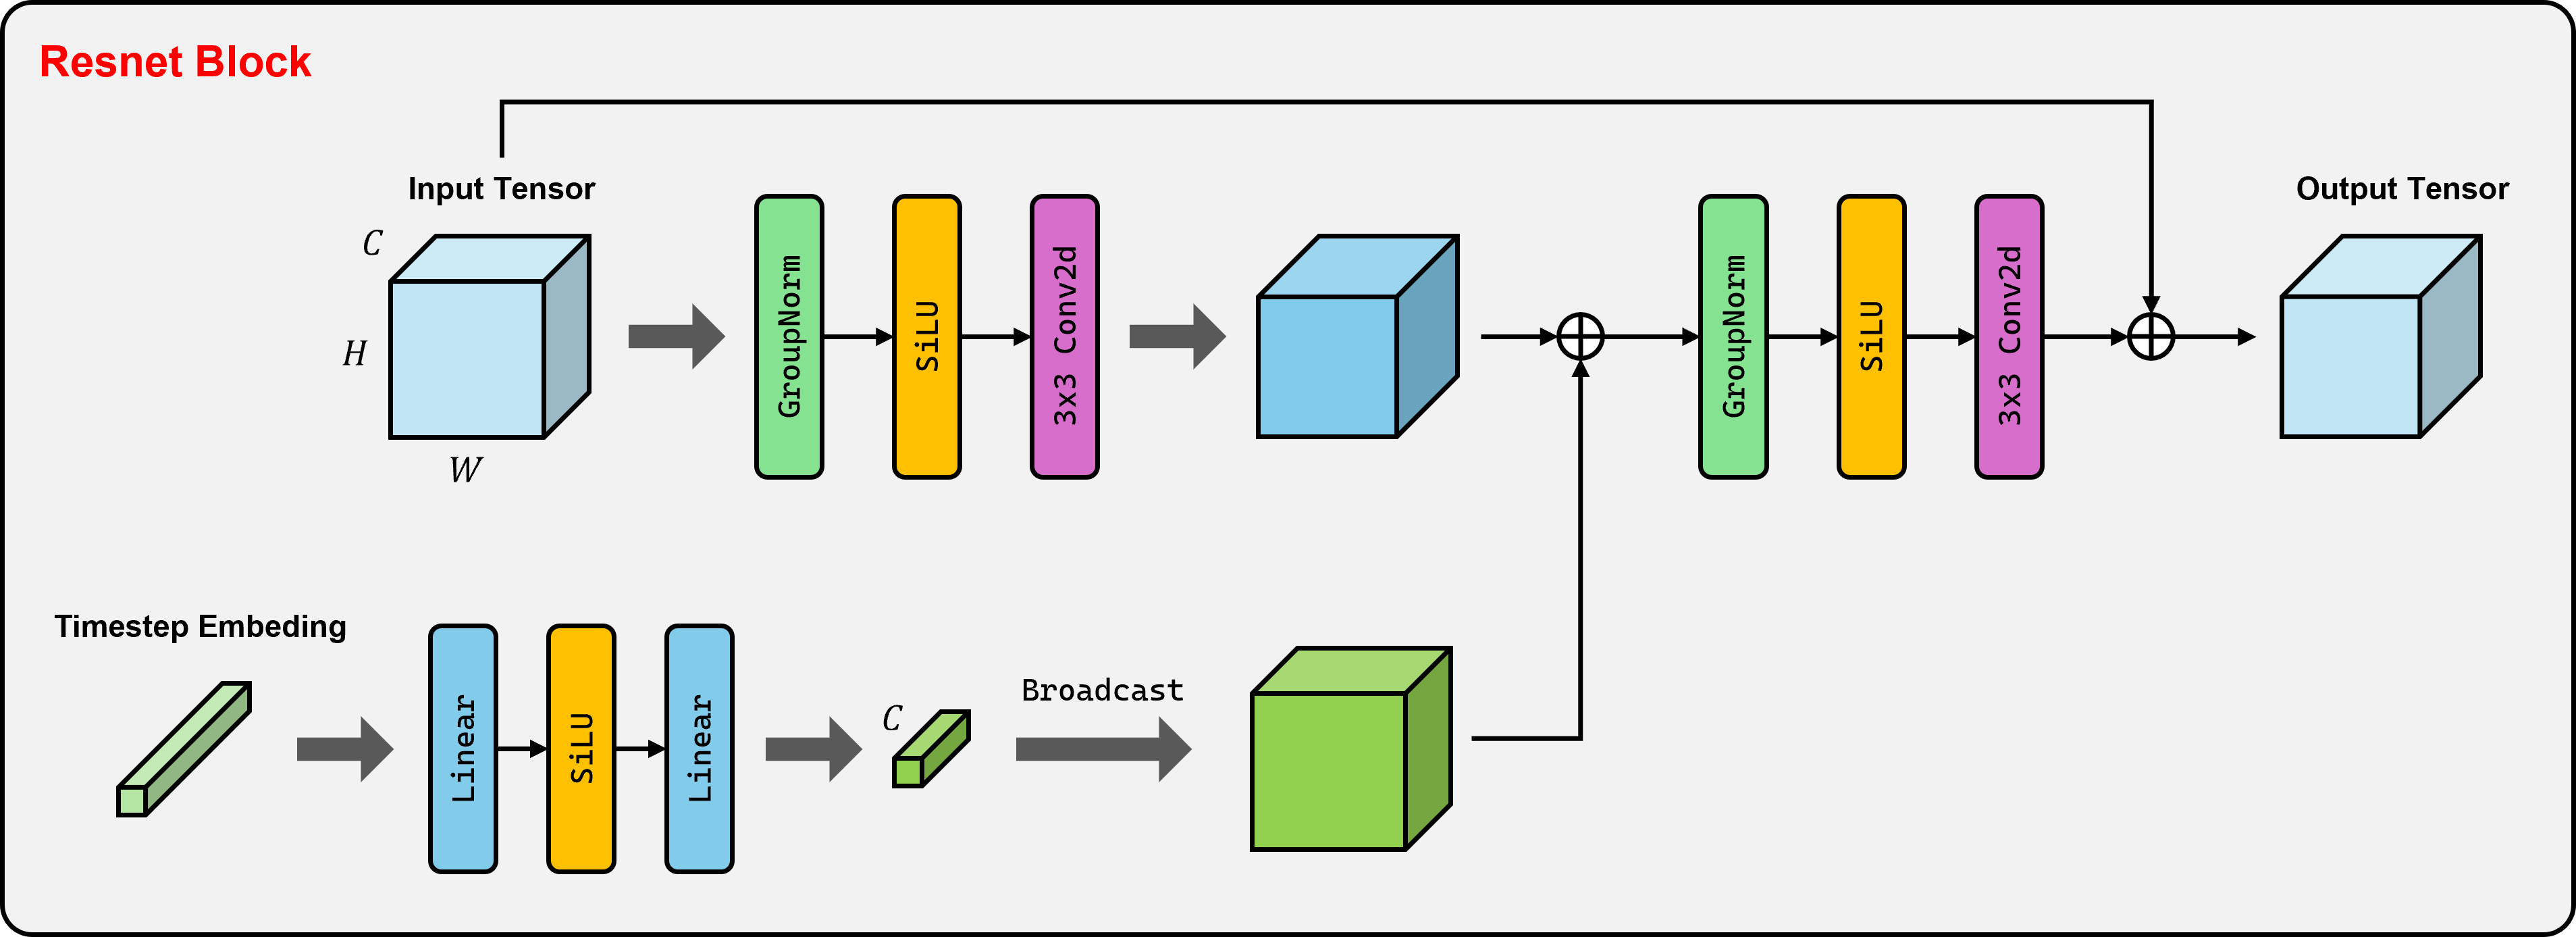
U-Net 그림에서 초록색 화살표에 해당하는 Resnet Block의 구조는 아래와 같다.
Noise Timestep $t$는 입력 텐서에 더해지는 형태로 주입된다.
Transformer Block
U-Net 그림에서 빨간색 화살표에 해당하는 Transformer Block의 구조는 아래와 같다.
CLIP 모델을 통해 전달된 텍스트 조건은 Key와 Value로 변환된 후, cross-attention 연산을 통해 주입된다.
\[\text{Cross-Attn}(Q^{\text{img}},K^{\text{context}},V^{\text{context}}) =\text{softmax}\left(\frac{Q^{\text{img}}\cdot (K^{\text{context}})^\top}{\sqrt{d_k}}\right) V^{\text{context}}\]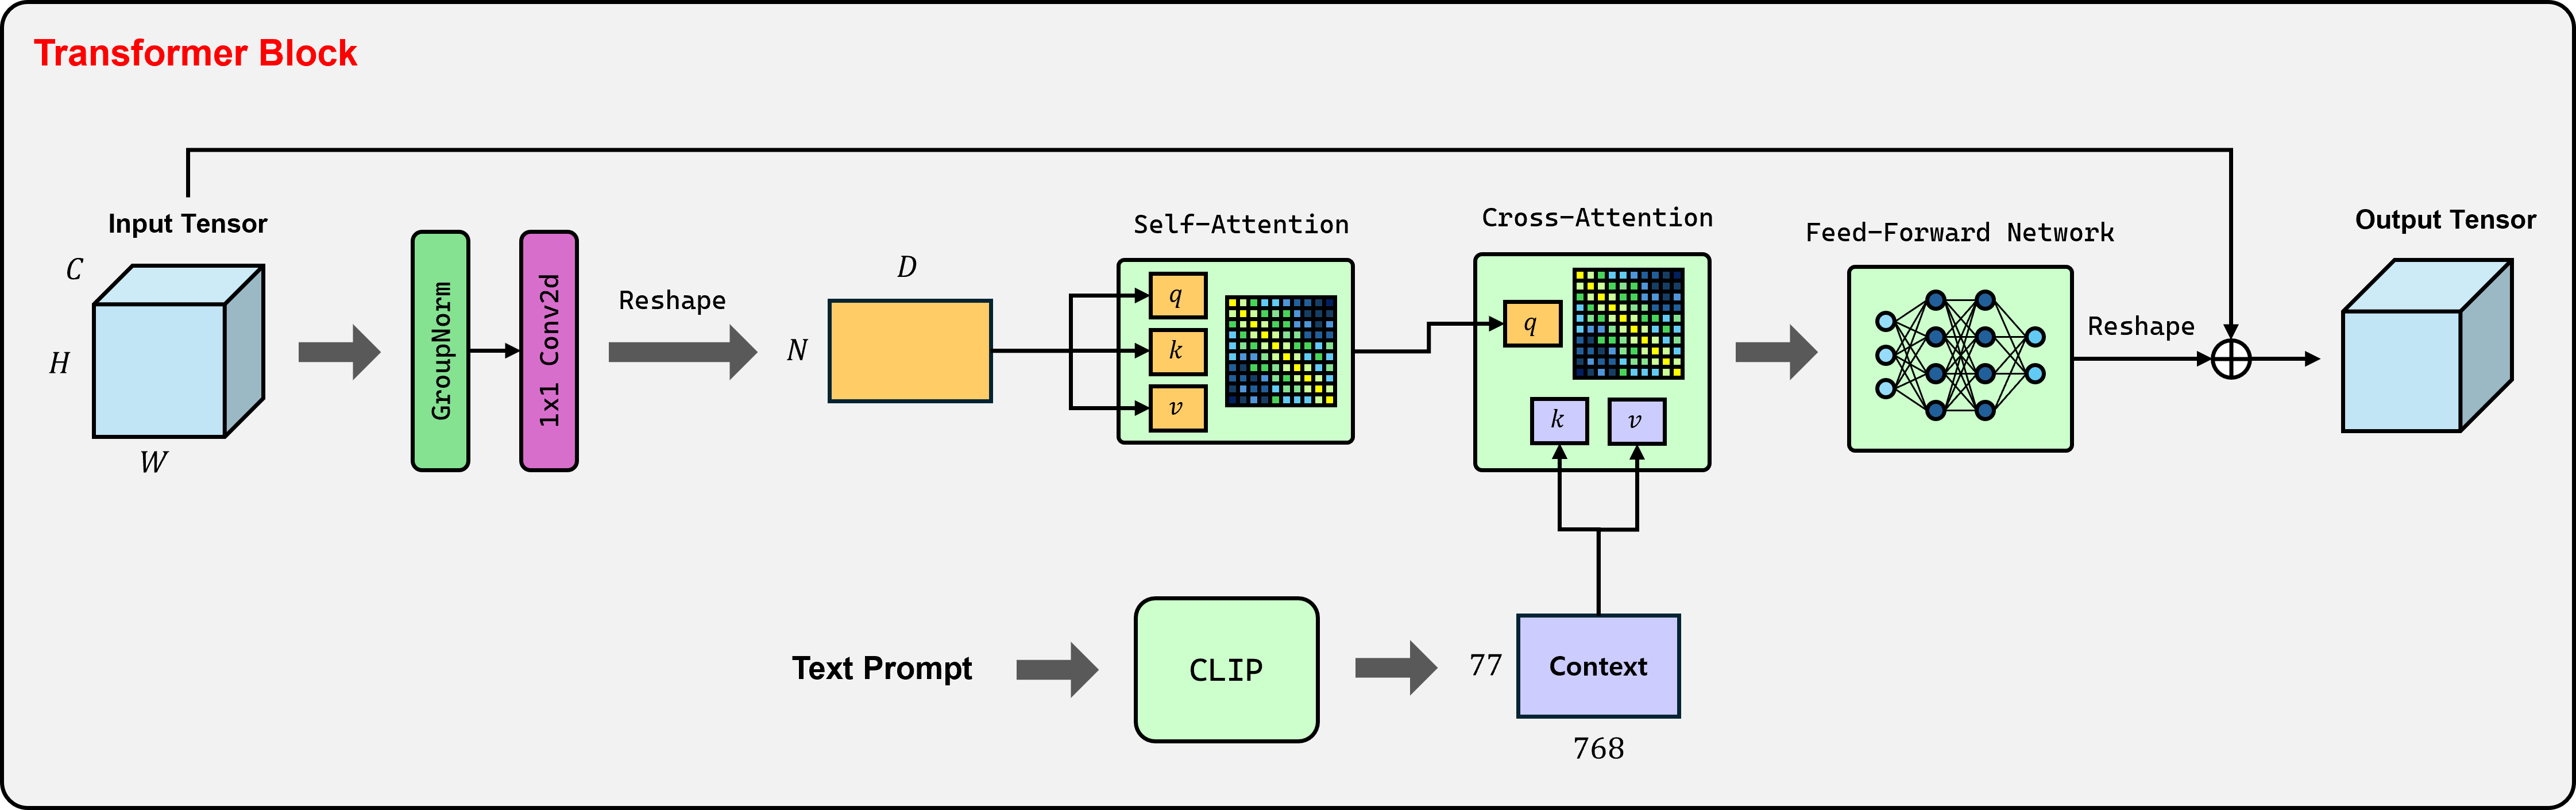
Upsampler & Downsampler
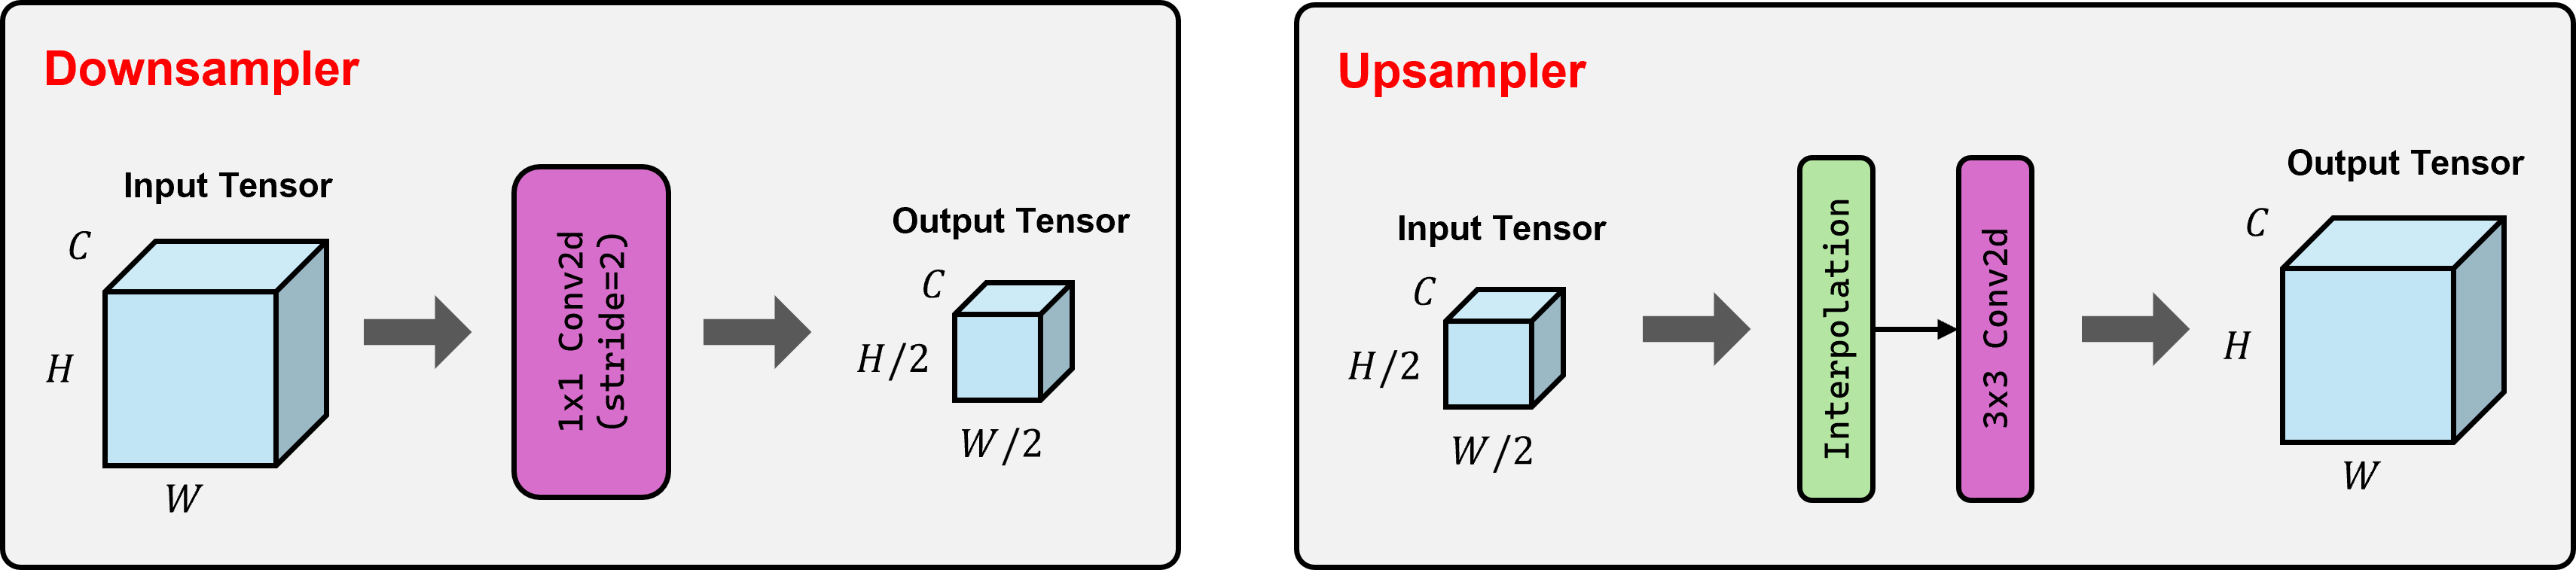
U-Net 그림에서 보라색 화살표에 해당하는 Downsampler와 Upsampler의 구조는 아래와 같다.
Downsampling의 Scale factor는 $0.5$, Upsampling의 Scale factor는 $2.0$이다.