DDPM (Denoising Diffusion Probabilistic Models)
📝 NeurIPS 2020
📄 관련 논문: [NeurIPS 2020] Denoising Diffusion Probabilistic Models
DDPM Process
DDPM은 크게 2가지 과정으로 구성되어 있다.
- Forward Process: 깨끗한 이미지에서 완전한 가우시안 노이즈로 만드는 과정
- Reverse Process: 완전한 가우시안 노이즈에서 깨끗한 이미지로 복원하는 과정 (Denoising Process 또는 Sampling Process라고도 함)
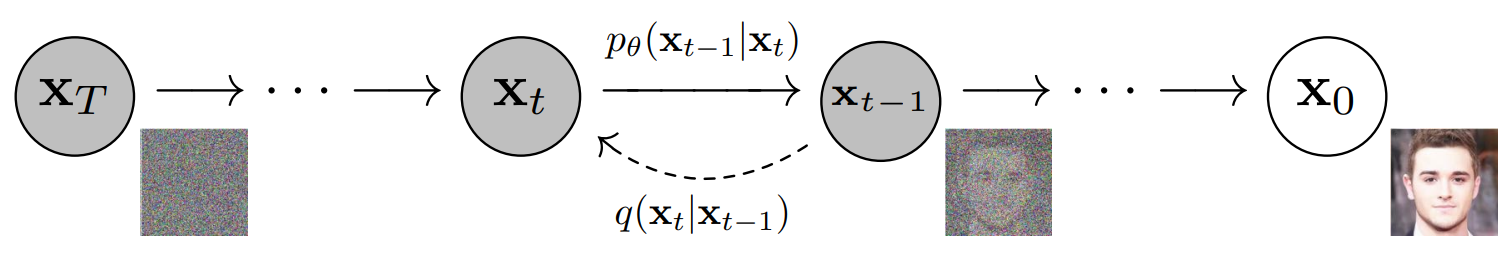
Forward Process
Forward Process는 원본 데이터 $\vx_0$에 가우시안 노이즈를 점진적으로 추가하여, 최종적으로 완전한 노이즈 분포인 $\mathcal{N}(0,\text{I})$로 만드는 과정이다.
저자들은 1step의 가우시안 노이즈 주입 과정을 다음과 같이 정의하였다.
\[q(\mathbf x_t\mid\mathbf x_{t-1}):= \mathcal{N}(\mathbf x_t;\sqrt{1-\beta_t}\mathbf x_{t-1},\beta_t\mathbf I) \tag{1}\]위 수식은 이전 step의 이미지의 강도를 $\sqrt{1-\beta_t}$만큼 감쇠시키고, 분산이 $\beta_t\vI$인 가우시안 노이즈를 더한다는 의미를 갖는다.
이를 Reparameterization Trick을 이용해 덧셈의 형태로 표현하면 다음과 같다.
또한 저자들은 이러한 노이즈 주입 과정에 Markovian 가정을 도입했다.
즉, 현재 상태 $\vx_t$는 오직 직전 상태인 $\vx_{t-1}$에만 의존한다.
이러한 성질 덕분에, $t=0$부터 $t=T$까지 연속적으로 노이즈를 주입하는 전체 과정 (Joint 분포)을 다음과 같이 각 step별 전이 확률 (Transition probability)의 연속적인 곱셈으로 표현할 수 있다.
\[q(\mathbf x_{1:T}\mid\mathbf x_0):=q(\vx_1\mid\vx_0) \tag{3}q(\vx_2\mid\vx_1)\cdots q(\vx_T\mid\vx_{T-1})\]결론적으로 Forward Process는 다음과 같이 정의된다.
\[q(\mathbf x_{1:T}\mid\mathbf x_0):=\prod_{t=1}^Tq(\mathbf x_t\mid\mathbf x_{t-1}) \tag{4}\]Variance Scheduler
식 (2)에 등장하는 $\beta_t$를 Variance Scheduler라고 부르며, 이는 매 step $t$마다 이전 step의 정보를 얼마나 유지하고 새로운 노이즈를 얼마나 섞을지를 결정하는 파라미터이다.
Linear, Cosine 등 여러 스케줄러 함수가 있지만, 대부분의 Variance Scheduler는 공통적으로 다음과 같은 규칙을 따른다.
- 노이즈 주입 초반 단계 ($t$가 작을 때): 이미지의 구조가 순식간에 파괴되는 것을 방지하기 위해 $\beta_t$를 매우 작은 값으로 설정한다.
- 노이즈 주입 후반 단계 ($t$가 클 때): 데이터를 완전한 가우시안 노이즈로 빠르게 수렴시키기 위해 $\beta_t$를 더 큰 값으로 설정한다.
결과적으로 주입되는 노이즈의 강도가 고정되어 있지 않고 진행 단계에 따라 유동적으로 변해야 하므로, $\beta_t$는 타임스텝 $t$에 종속된 함수로 정의된다.
Closed-form Sampling
앞선 정의대로라면 $\vx_t$를 구하기 위해 $1$부터 $t$까지 매 step마다 연산을 반복해야 할 것 같지만, 실제로는 원본 데이터 $\vx_0$에서 임의의 time step $t$의 상태를 한 번에 계산할 수 있는 Closed-form 수식이 존재한다.
이를 위해 $\alpha_t:=1-\beta_t$와 누적된 곱을 의미하는 $\bar\alpha_t:=\prod_{s=1}^t\alpha_s$를 새롭게 정의하면, Marginal 분포를 다음과 같이 전개할 수 있다.
\[q(\mathbf x_t\mid\mathbf x_0)=\mathcal{N}(\mathbf x_t;\sqrt{\bar\alpha_t}\mathbf x_0,(1-\bar\alpha_t)\mathbf I) \tag{5}\]따라서 실제 코드에서는 $t$번의 Markov Chain을 일일이 거치지 않고, 임의의 step $t$에 대한 노이즈 낀 이미지를 바로 샘플링한다.
하지만 확률 변수에서 값을 직접 샘플링하는 과정은 미분이 불가능하므로, 역전파 또한 불가능하다.
이를 위해 Reparameterization Trick을 사용하여 수식을 무작위성과 결정론적 연산으로 분리한다.
결과적으로 아래와 같이 덧셈 형태로 변형하여 실제 코드에 구현된다.
Reverse Process (Training)
Reverse Process는 완전한 노이즈 분포 $\vx_T\sim\mathcal{N}(0,\text{I})$에서 노이즈를 점진적으로 제거함으로써, 원본 데이터 $\vx_0$를 복원하는 과정이다.
이론적으로 Forward Process의 각 노이즈 주입 step이 매우 작다면, 그 역방향의 확률 궤적 역시 동일하게 가우시안 분포의 형태를 띤다는 것이 알려져 있다.
실제 역방향 분포의 계산 불가능성 (Intractability)
이를 수학적으로 구하기 위해 베이즈 정리를 적용하면, Reverse Process의 1step은 다음과 같이 표현된다.
\[q(\vx_{t-1}\mid\vx_t)=\frac{q(\vx_t\mid\vx_{t-1})q(\vx_{t-1})}{q(\vx_t)} \tag{7}\]위 수식에서 $q(\vx_t\mid\vx_{t-1})$는 우리가 직접 정의한 분포이기 때문에 알고 있다.
하지만 $q(\vx_{t-1})$와 $q(\vx_t)$는 우리가 알 수 없는 전체 데이터셋의 Marginal 분포이다.
따라서 실제 역방향 분포 $q(\vx_{t-1}\mid\vx_t)$를 직접 계산하는 것은 불가능하다.
딥러닝 모델을 통한 근사
직접 계산이 불가능하므로, 저자들은 이를 학습 가능한 파라미터 $\theta$를 가진 딥러닝 모델 $p_\theta$로 근사하는 방식을 택하였다.
Reverse Process 역시 Markov Chain을 따른다고 가정하며, 모델이 예측하는 전체 Reverse Process는 아래와 같이 정의된다.
\[p_\theta(\mathbf x_{0:T}):=p(\vx_T)\prod_{t=1}^Tp_\theta(\vx_{t-1}\mid\vx_t) \tag{8}\]Tractable Posterior의 유도
그렇다면 모델 $p_\theta(\vx_{t-1}\mid\vx_t)$를 도대체 어떤 정답을 보고 학습시켜야 할까?
다행히도 우리는 생성 모델을 학습시킬 때, 원본 데이터 $\vx_0$를 가지고 있다.
앞서 확인했듯이 직전 step만을 고려하는 $q(\vx_{t-1}\mid\vx_t)$는 구할 수 없지만, 여기에 원본 이미지 $\vx_0$를 조건부를 추가하면 베이즈 정리와 Forward Process의 성질을 이용해 Closed-form의 가우시안 분포를 유도할 수 있다.
\[q(\vx_{t-1}\mid\vx_t,\vx_0) = \mathcal{N}(\vx_{t-1};\tilde{\mu}_t(\vx_t,\vx_0),\tilde{\beta}_t\vI) \tag{9}\]이 분포의 평균 $\tilde{\mu}_t$와 분산 $\tilde{\beta}_t$는 아래와 같이 $\vx_t$와 $\vx_0$에 대한 선형 결합으로 도출된다.
\[\tilde{\mu}_t(\vx_t,\vx_0)= \frac{\sqrt{\bar{\alpha}_{t-1}}\beta_t}{1-\bar{\alpha}_t}\vx_0 +\frac{\sqrt{\alpha_t}(1-\bar{\alpha}_{t-1})}{1-\bar{\alpha}_t}\vx_t \quad,\quad \tilde{\beta}_t=\frac{1-\bar{\alpha}_{t-1}}{1-\bar{\alpha}_t}\beta_t \tag{10}\]결론적으로, 딥러닝 모델 $p_\theta$는 이 분포를 근사하도록 학습된다.
DDPM 원논문에서는 딥러닝 모델이 평균만 예측하도록 하고, 분산을 학습하지 않는 상수 $\sigma_t^2\vI$로 고정했다.
이후 발표된 Improved Denoising Diffusion Probabilistic Models 논문에서는 이 분산까지 모델이 직접 학습하도록 구조를 개선하여, 더 적은 step으로도 높은 퀄리티의 이미지를 생성할 수 있게 되었다.
Reverse Process (Inference)
학습이 완료된 후 새로운 이미지를 생성할 때는, 완전한 가우시안 노이즈 $\vx_T$에서 출발하여 아래의 수식을 통해 매 step마다 점진적으로 노이즈를 걷어낸다.
\[\vx_{t-1}=\frac{1}{\sqrt{\alpha_t}}\bigg( \vx_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\boldsymbol\epsilon_\theta(\vx_t,t) \bigg)+\sigma_t\vz ,\quad\text{where }\vz\sim\mathcal{N}(\mathbf0,\vI) \tag{11}\]이 과정을 $t=T$부터 $t=1$까지 역순으로 반복하면 최종적으로 깨끗한 원본 이미지 형태의 $\vx_0$를 얻게 된다.
Training Objective
생성 모델의 궁극적인 목표는 모델이 생성한 데이터가 실제 데이터의 분포를 따르도록 Log-likelihood를 최대화하는 것이다.
하지만 이 Log-likelihood를 직접 계산하는 것은 불가능하므로, VAE와 마찬가지로 ELBO (Evidence Lower Bound)를 사용해 Negative Log-likelihood의 상한선을 최소화하는 방식으로 학습을 진행한다.
\[\mathbb{E}\big[-\log p_\theta(\vx_0)\big]\leq \mathbb{E}_q\bigg[ -\log p(\vx_T)-\sum_{t\geq1}\log\frac{p_\theta(\vx_{t-1}\mid\vx_t)}{q(\mathbf x_t\mid\mathbf x_{t-1})} \bigg]:=L \tag{12}\]Markov Chain 성질과 Tractable Posterior을 활용하면, 우항의 ELBO 수식을 아래와 같이 3개의 항으로 분리할 수 있다.
\[\mathbb{E}_q \Bigg[ \underbrace{D_{\mathrm{KL}}\left(q(\vx_T \mid \vx_0) \,\|\, p(\vx_T)\right)}_{L_T} + \underbrace{\sum_{t > 1} D_{\mathrm{KL}}\left(q(\vx_{t-1} \mid \vx_t, \vx_0) \,\|\, p_\theta(\vx_{t-1} \mid \vx_t)\right)}_{L_{t-1}} - \underbrace{\log p_\theta(\vx_0 \mid \vx_1)}_{L_0} \Bigg] \tag{13}\]- $L_T$ (Regularization Loss): $\beta_t$를 학습시키는 항이지만 실험에서는 $\beta_t$를 고정된 하이퍼파라미터로 두기 때문에 무시할 수 있는 항이다.
- $L_{t-1}$ (Denoising Loss): 모델의 핵심 학습 대상이며, 매 step에서 예측한 분포와 실제 분포의 차이를 최소화하는 항이다.
- $L_0$ (Reconstruction Loss): Reverse Process의 마지막 step ($t=1\to0$)에서 이미지를 복원하는 항으로, 정제된 이미지를 생성하는 항이다.
Simplified Training Objective
저자들은 아래와 같이 단순화한 목적함수를 사용했을 때 더 좋은 샘플을 생성하는 것을 실험적으로 확인했다고 한다.
\[L_{\text{simple}}(\theta):= \mathbb{E}_{t,\mathbf x_0,\boldsymbol\epsilon} \bigg[\lVert\boldsymbol\epsilon-\boldsymbol\epsilon_\theta(\vx_t,t)\rVert^2\bigg] \tag{14}\]위 수식에서 $\vx_t=\sqrt{\bar\alpha_t}\mathbf x_0+\sqrt{1-\bar\alpha_t}\boldsymbol\epsilon$이다.
식 (14)의 단순화된 손실 함수에 따르면, 모델 $\boldsymbol\epsilon_\theta$는 원본 데이터 $\vx_0$에서 현재 상태 $\vx_t$를 만들기 위해 주입된 전체 노이즈 $\boldsymbol\epsilon$을 예측하도록 학습된다.
Pseudo Code
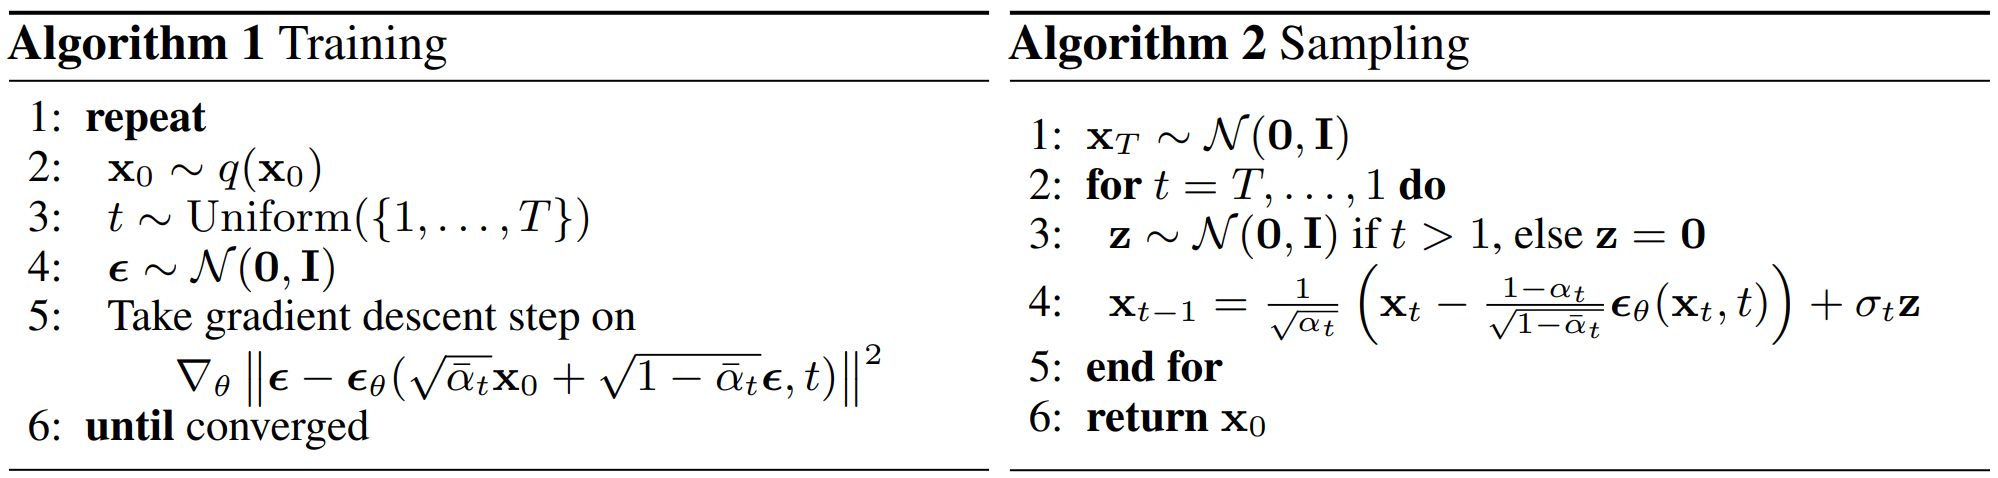
Training
- $t$를 $[1,T]$ 범위에서 랜덤으로 샘플링한다.
- $q(\mathbf x_t\mid\mathbf x_0)$ 수식을 이용해 해당 $t$에서의 노이즈 이미지를 생성한다.
- 모델 $\boldsymbol\epsilon_\theta$는 생성된 $\mathbf x_t$와 $t$를 입력받아, $\mathbf x_t$에 주입된 전체 노이즈 $\vepsilon$를 예측한다.
- 식 (14)의 MSE Loss를 구한 후, 역전파를 통해 파라미터를 업데이트한다.
- 위 과정을 epoch만큼 반복한다.
여기서 유의할 점은, 하나의 이미지를 학습할 때 $t$를 거꾸로 내려오면서 모든 step에 대해 Loss를 구하고 역전파를 하지 않는다는 것이다.
대신, 저자들은 매번 무작위 $t$를 하나만 뽑아 한 번에 예측하는 방식을 사용했다.
수많은 이미지 데이터셋에서 이 무작위 추출 과정을 반복하다 보면, 모델은 결국 $t=1$부터 $T까지 전체 구간에 걸친 노이즈 제거 패턴을 자연스럽게 학습하게 된다.
Inference
- $\vx_T$를 $\mathcal{N}(\mathbf0,\vI)$에서 샘플링한다.
- 현재 time step이 $t>1$이라면, $\vz$를 $\mathcal{N}(\mathbf0,\vI)$에서 샘플링한다.
- 현재 $\mathbf x_t$와 $t$를 입력으로 하여, 네트워크가 해당 time step에서의 노이즈를 예측한다.
- 예측된 노이즈를 바탕으로 $\mathbf x_{t-1}$을 계산한다.
- (2)~(4) 과정을 $t=T,\dots,1$ 동안 반복한다.
- 최종적으로 $\mathbf x_0$를 얻는다.