커널 트릭 (Kernel Trick)
커널 트릭 (Kernel Trick)
SVM은 기본적으로 데이터를 선으로 분류하는 선형 분류기다. 하지만 현실의 대부분의 데이터는 선으로 깔끔하게 나눌 수 없는 경우가 많다.
아래 그림처럼, 저차원 공간에서는 선형 분리가 안되는 데이터일지라도 고차원 공간에서는 선형 분리가 가능할 수도 있다.
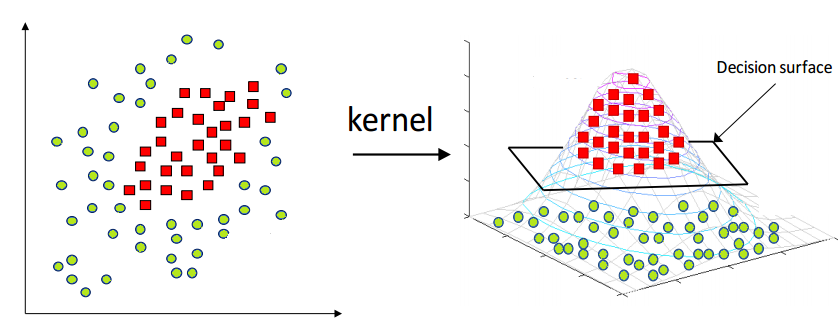
이를 위해 SVM은 입력 데이터를 더 높은 차원의 특징 공간으로 매핑하는 함수 $\phi(\cdot)$를 사용한다.
즉, 매핑 함수 $\phi(\cdot)$를 이용해 데이터를 고차원 공간으로 변환함으로써, 원래 공간에서는 비선형적으로 분포하던 데이터를 고차원 공간에서는 선형 분리되도록 만든다.
하지만 SVM의 학습 과정에서는 모든 샘플 쌍 $(\vx^{(i)},\vx^{(j)})$ 간의 내적을 계산해야하기 때문에, 모든 데이터를 실제로 고차원으로 매핑하여 계산하면 계산량이 매우 커진다.
Soft Margin SVM에서 라그랑주 함수는 아래와 같다.
\[\mathcal{L}=\sum_{i=1}^N\mu^{(i)}-\frac{1}{2}\sum_{i=1}^N\sum_{j=1}^N\mu^{(i)}\mu^{(j)}y^{(i)}y^{(j)}\color{red}{\vx^{(i)}}^\top\vx^{(j)}\]비선형 데이터인 경우, 입력 벡터 $\vx$를 $\phi(\vx)$로 대체한다.
\[\mathcal{L}=\sum_{i=1}^N\mu^{(i)}-\frac{1}{2}\sum_{i=1}^N\sum_{j=1}^N\mu^{(i)}\mu^{(j)}y^{(i)}y^{(j)}\color{red}{\phi(\vx^{(i)})}^\top\phi(\vx^{(j)})\]여기서 우리가 필요한 것은 $\phi(\vx)$ 값 자체가 아니라, 두 벡터의 내적값 ${\vx^{(i)}}^\top\vx^{(j)}$이다.
따라서 이 내적을 직접 계산하지 않고도 동일한 결과를 얻기 위해 커널 함수 (kernel function) $K(\cdot,\cdot)$를 정의한다.
\[K(\vx^{(i)},\vx^{(j)})=\langle\phi(\vx^{(i)}),\phi(\vx^{(j)})\rangle\]커널 함수를 이용해, 라그랑주 함수를 아래와 같이 표현할 수 있다.
\[\mathcal{L}=\sum_{i=1}^N\mu^{(i)}-\frac{1}{2}\sum_{i=1}^N\sum_{j=1}^N\mu^{(i)}\mu^{(j)}y^{(i)}y^{(j)}\color{red}K(\vx^{(i)},\vx^{(j)})\]커널 ‘트릭’이라고 부르는 이유는 데이터를 직접 고차원으로 매핑하지 않아도 원래 입력 공간에서 $K(\cdot,\cdot)$만 계산하면, 고차원 공간에서의 내적과 동일한 효과를 얻을 수 있기 때문이다.
즉, 우리는 $\phi(\cdot)$가 무엇인지 알 필요도, 실제로 계산할 필요도 없다.
Example 1
2차원 벡터 $\vx,\vy$가 있다고 가정하자.
\[\vx=\begin{bmatrix}x_1\\x_2\end{bmatrix}\in\mathbb{R}^2~~,~~ \vy=\begin{bmatrix}y_1\\y_2\end{bmatrix}\in\mathbb{R}^2\]위의 커널 함수에 데이터를 입력하면 아래와 아래와 같이 전개된다.
\[K(\vx,\vy)=(x_1y_1+x_2y_2+1)^2= 1+2x_1y_1+2x_2y_2+(x_1y_1)^2+(x_2y_2)+2(x_1y_1)(x_2y_2)\]이 식은 원래 2차원 입력이 고차원 공간에서의 내적으로 표현된 형태임을 보여준다.
\[K(\vx,\vy)={\phi(\vx^{(i)})}^\top\phi(\vx^{(j)})= \begin{bmatrix}1\\\sqrt2x_1\\\sqrt2x_2\\x_1^2\\x_2^2\\\sqrt2x_1x_2\end{bmatrix} \begin{bmatrix}1&\sqrt2y_1&\sqrt2y_2&y_1^2&y_2^2&\sqrt2y_1y_2\end{bmatrix}\]위의 식에 따르면, 매핑 함수는 아래와 같다는 것을 확인할 수 있다.
\[\phi(\vx)=\begin{bmatrix} 1\\\sqrt2x_1\\\sqrt2x_2\\x_1^2\\x_2^2\\\sqrt2x_1x_2 \end{bmatrix}\in\mathbb{R}^6~~,~~ \phi(\vy)=\begin{bmatrix} 1\\\sqrt2y_1\\\sqrt2y_2\\y_1^2\\y_2^2\\\sqrt2y_1y_2 \end{bmatrix}\in\mathbb{R}^6\]따라서 2차원 공간의 벡터가 6차원 공간의 벡터로 매핑되었다.
즉, 입력을 실제로 6차원으려 변환하지 않았지만, 결과적으로는 6차원 공간에서의 내적과 동일한 효과를 냈다.