KV Cahce
📄 관련 논문: [arXiv 2019] Fast Transformer Decoding: One Write-Head is All You Need
📄 관련 논문: [EMNLP 2023] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
캐시(Cache)란 자주 사용되거나 다시 계산하는 데 비용이 큰 데이터를 미리 저장해 두었다가, 필요할 때 빠르게 재사용하기 위한 임시 저장소를 의미한다.
KV Cache에서의 Cache 역시 동일한 개념이다.
트랜스포머가 토큰을 생성하는 과정에서 한 번 계산한 Key와 Value 벡터를 저장해 두고, 이후 step에서 다시 계산하지 않고 재사용하는 기법이다.
기존 트랜스포머에서의 문제점
LLM은 텍스트를 생성할 때 Autoregressive 방식을 사용한다.
즉, 지금까지의 입력 토큰과 이미 생성된 토큰들을 바탕으로 다음 토큰을 하나씩 예측하며 문장을 완성해 나간다.
예를 들어 GPT에게 다음과 같은 질문을 하고 답변을 얻었다고 가정해 보자.
1
2
3
User: Can you explain LLMs?

GPT : Sure. Large Language Models (LLMs) are AI systems trained to understand and generate human language.
이 답변은 실제로 한 번에 생성되는 것이 아니라, 아래와 같이 토큰 단위로 순차적으로 생성된다.
- Step1: $\vx=\text{Can you explain LLMs?}\quad\to\quad y=\text{Sure}$
- Step2: $\vx=\text{Can you explain LLMs? Sure}\quad\to\quad y=\text{.}$
- Step3: $\vx=\text{Can you explain LLMs? Sure.}\quad\to\quad y=\text{Large}$
- Step4: $\vx=\text{Can you explain LLMs? Sure. Large}\quad\to\quad y=\text{Language}$
- $\dots$
그렇다면, 실제 GPT와 같은 Decoder-only 트랜스포머에서 다음 토큰이 생성되는 과정을 보자.
트랜스포머의 마지막 layer를 통과한 각 토큰의 hidden state는, Linear projection과 Softmax를 거쳐 다음에 올 토큰의 확률 분포를 나타내게 된다.
즉, $i$번째 토큰에 대한 출력은 $i$번째 토큰 다음에 올 토큰의 확률 분포를 의미한다.
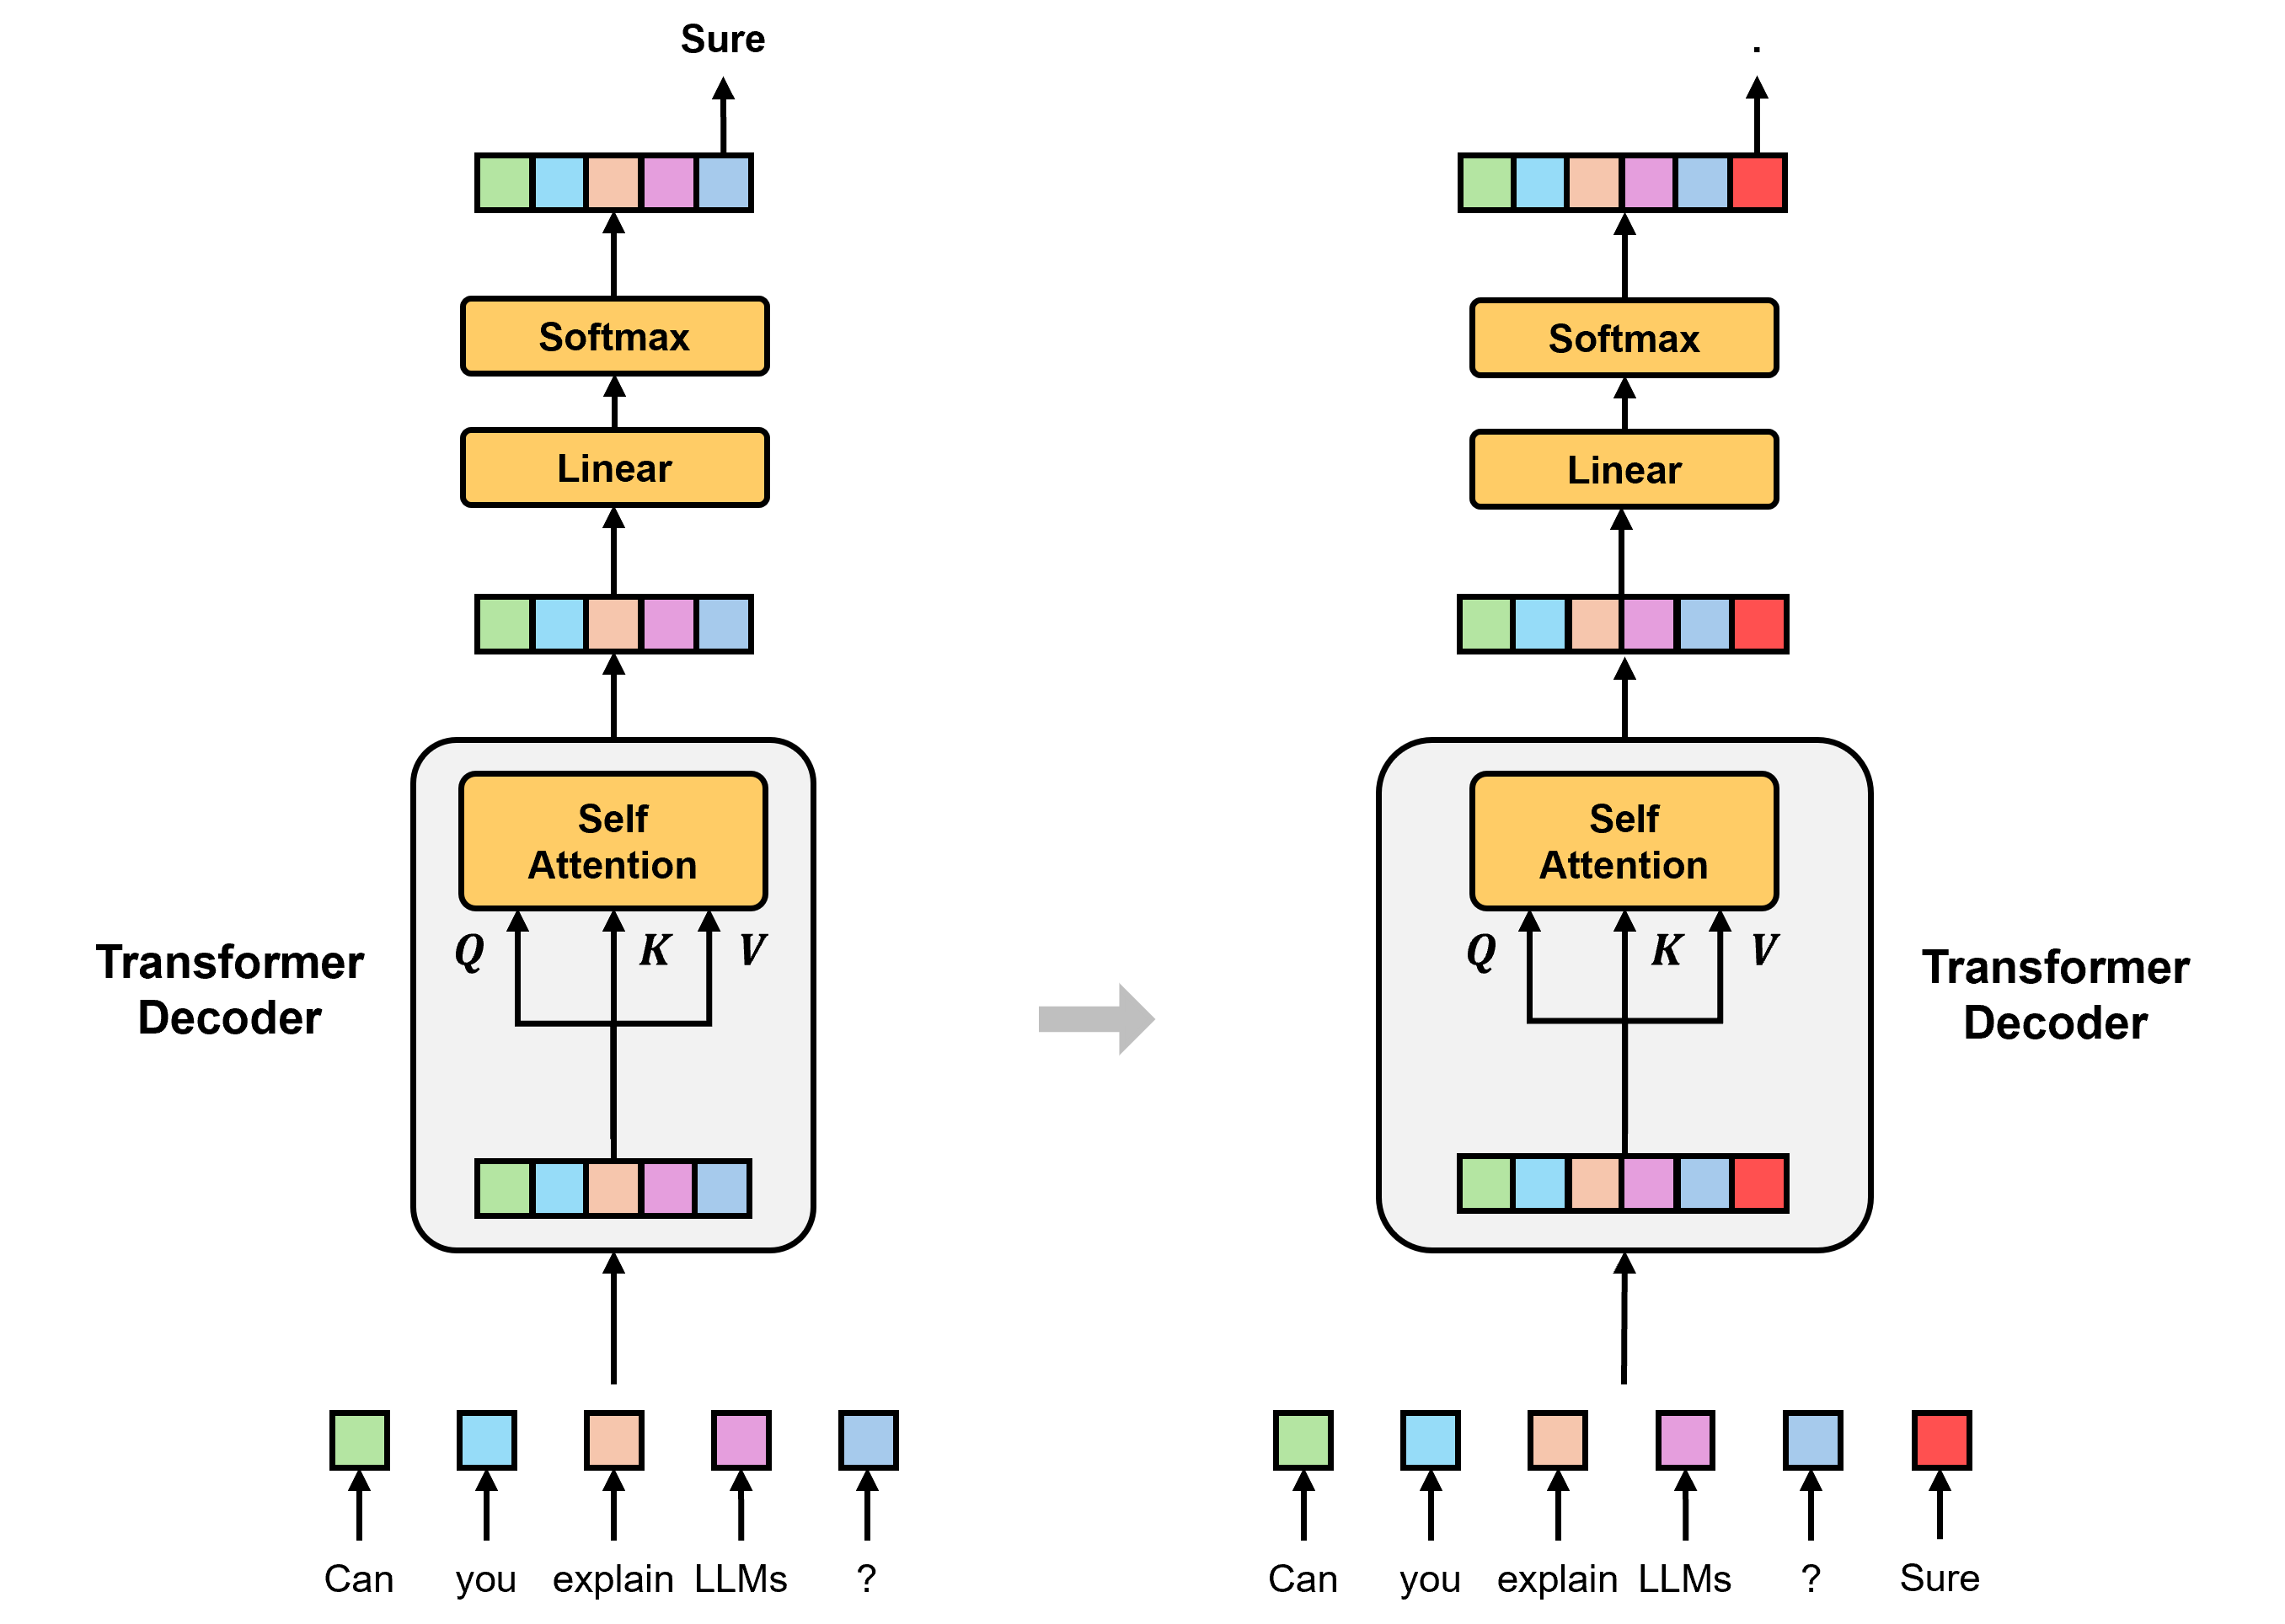
추론 때는 다음 토큰 하나만 생성하면 되기 때문에, 마지막 토큰의 확률 분포만 사용하고 앞의 토큰들은 모두 버린다.
문제는 우리는 마지막 토큰의 출력만 필요하지만, 매 단계에서 새로운 토큰이 생성될 때마다 Self-Attention에서는 과거 토큰들에 대한 Query, Key, Value를 매번 다시 계산한다는 것이다.
\[Q=\vx_{1:N}\cdot W_Q\quad,\quad K=\vx_{1:N}\cdot W_K\quad,\quad V=\vx_{1:N}\cdot W_V\]토큰의 차원을 $D$, 현재 시퀀스의 길이를 $N$이라고 하자.
매 단계마다 모든 토큰의 $Q,K,V$를 만드는 데 필요한 연산량은 각각 $O(ND^2)$이다.
또한 Self-Attention에서 행렬 곱셈 $QK^\top$를 수행하는 데 필요한 연산량은 $O(N^2D)$이다.
이 때문에 LLM이 답변을 이어가며 입력 시퀀스 길이 $N$이 길어질수록, 매 스텝당 필요한 연산량이 $N^2$에 비례하여 기하급수적으로 증가하게 된다.
이러한 추론 단계의 비효율성을 해결하기 위해 등장한 기법이 KV Cache이다.
KV Cache
추론에서 마지막 위치의 출력만 필요하다면, Query 역시 마지막 위치의 토큰 $\vx_N$ 하나만 계산하면 충분하다.
하지만 새로운 토큰의 $Q_N$ 하나로 Attention을 수행하려 해도, 연산 공식상 $K, V$는 여전히 과거 모든 토큰을 포함한 전체 시퀀스 정보가 필요하다는 문제점이 있다.
Autoregressive 모델에서는 학습과 추론 모두에서 미래 토큰을 참조하지 못하도록 Causal mask를 사용한다.
즉, $i$번째 위치의 $Q$는 자기 자신을 포함한 이전 위치의 $K$에만 Attention할 수 있다.
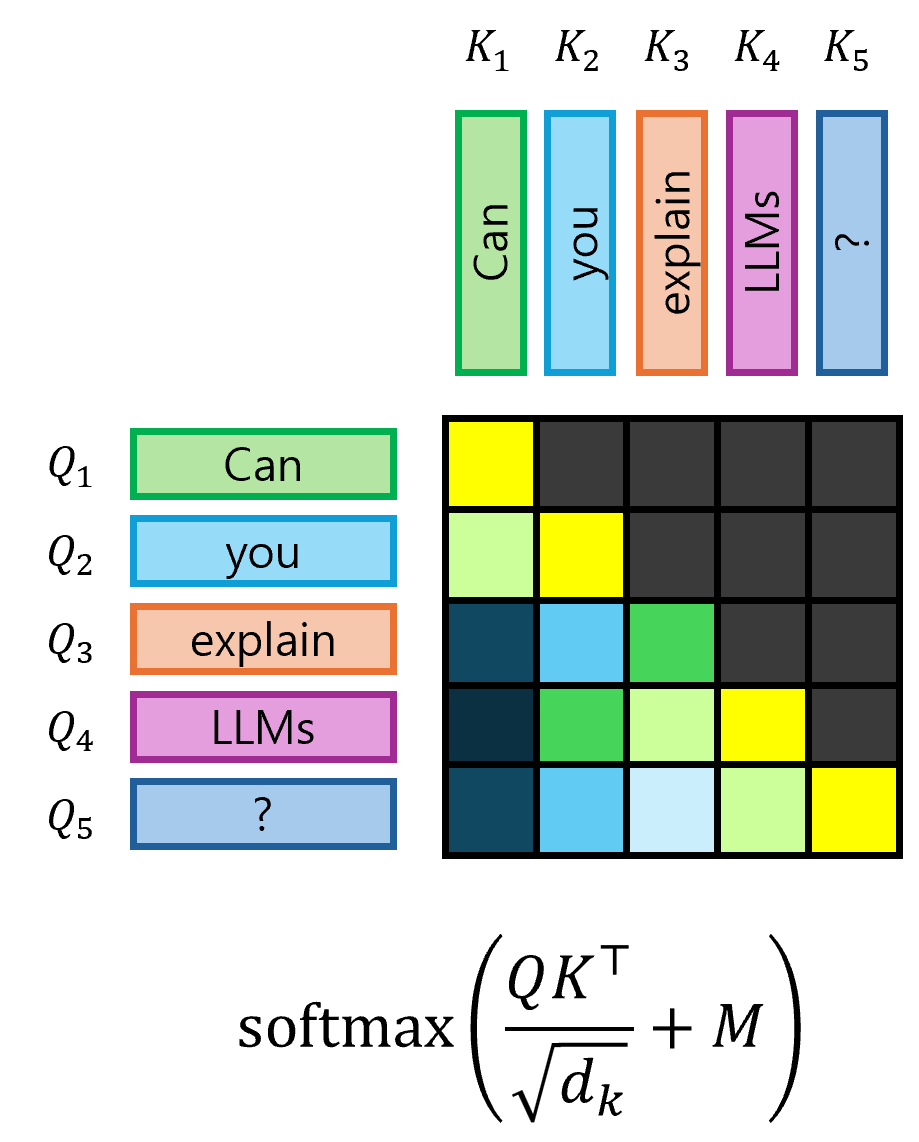
이 Causal mask 덕분에, 새로운 토큰이 추가되어 $K_{N+1}, V_{N+1}$이 생기더라도 다음 2가지가 보장된다.
- 입력과 가중치가 고정되어 있으므로, 과거 토큰들의 $K, V$ 값 자체는 절대 변하지 않는다.
- Causal mask가 새로 추가된 $K_{N+1}$ 자리를 $-\infty$로 가려주기 때문에, 과거 토큰들이 서로 주고받은 Attention 출력값 (아래 그림에서 빨간색 박스)도 변하지 않는다.
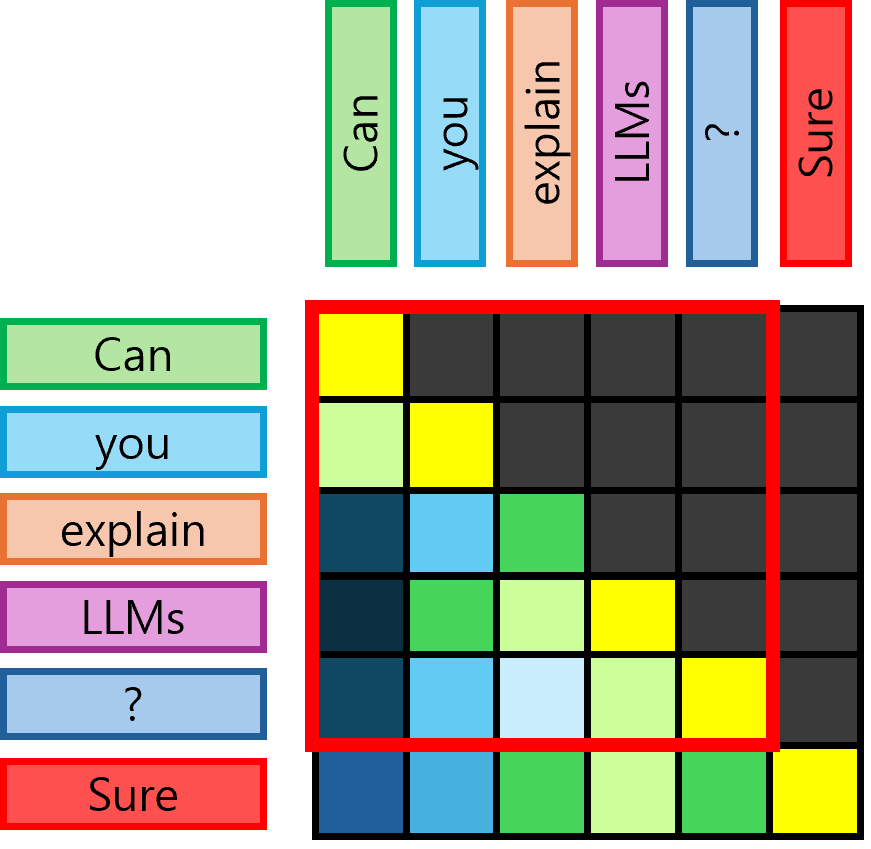
따라서 한 번 계산해 둔 과거 토큰들의 $K$와 $V$를 다음 단계에서 그대로 재사용해도 결과가 달라지지 않는다는 것이 보장된다.
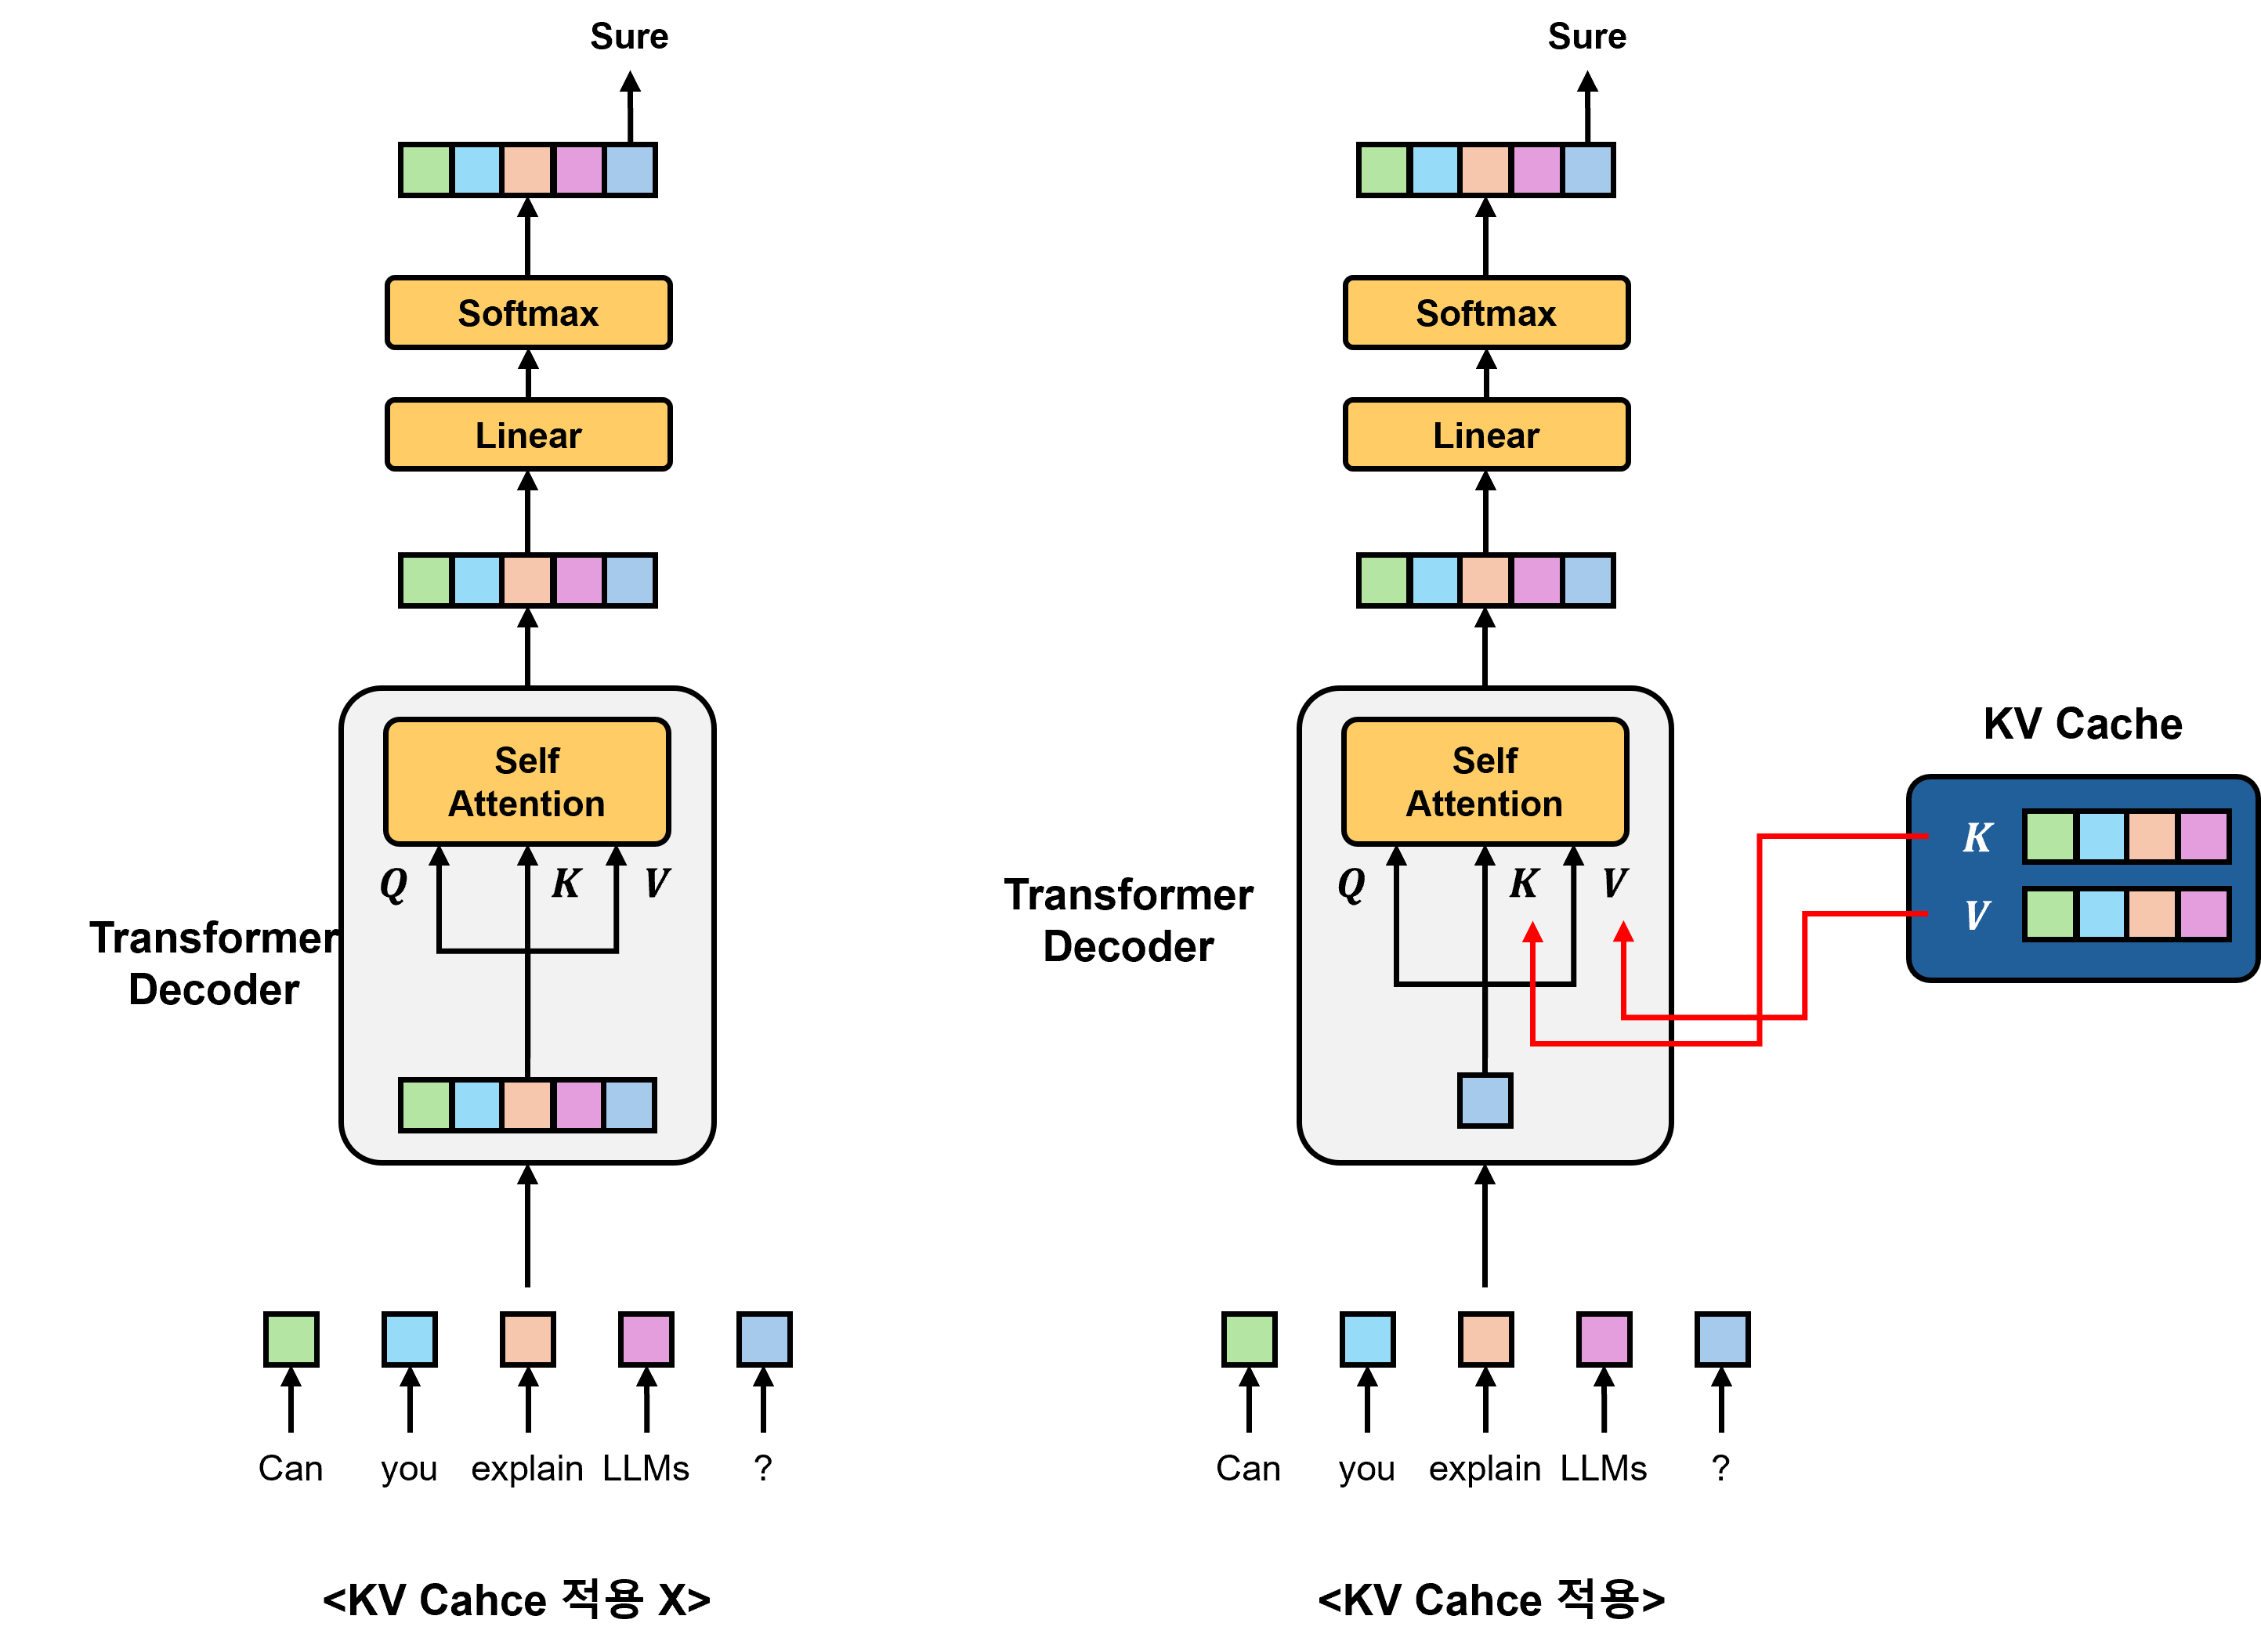
이 원리를 이용해 매 단계마다 $K$와 $V$를 처음부터 재계산할 필요 없이, GPU VRAM에 저장해 두었다가 꺼내 쓰는 것이 KV Cache의 핵심이다.
- KV Cache 적용 시 단일 스텝 동작 과정 1. 마지막에 새로 들어온 $N$번째 토큰 1개에 대해서만 $Q_N,K_N,V_N$ 생성한다. → 연산량: $O(D^2)$ 2. 새로 계산된 $K_N,V_N$을 KV Cache에 추가한다. 3. KV Cache에서 이전 토큰들의 Key, Value 정보를 가져와, 전체 시퀀스의 $K_{1:N},V_{1:N}$을 구성한다. 4. $Q_N$과 $K_{1:N}^\top$의 내적을 통해 Attention score를 계산한다. → 연산량: $O(ND)$
결론적으로, 매 스텝마다 마지막 토큰에 대해서만 $Q,K,V$를 생성하고 이전 토큰들의 $K$와 $V$는 Cache에서 꺼내어 쓰기 때문에, 연산량이 매우 줄어들어 빠른 추론이 가능해진다.
- QKV projection: $O(ND^2)\to O(D^2)$
- Attention: $O(N^2D)\to O(ND)$
Memory-Bound Problem
KV Cache 덕분에 추론 때의 연산량 문제는 해결되었지만, GPU VRAM을 극심하게 소모하는 Memory-Bound 현상을 유발한다.
KV Cache는 문장이 길어질수록 ($N$이 증가할수록), 동시 요청이 많아질수록 ($B$가 증가할수록)이 많아질수록, KV Cache가 차지하는 VRAM 용량이 매우 커지게 된다.
결국 GPU Core의 연산 능력은 놀고 있는데, 메모리가 부족해서 일을 못 하는 병목 상태에 빠지게 된다.
MQA & GQA
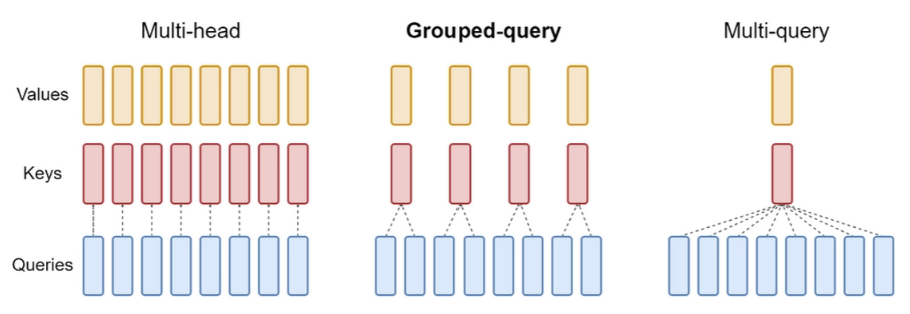
MQA와 GQA는 기존 트랜스포머의 Multi-Head Attention (MHA) 구조를 변형하여, 애초에 저장해야 할 $K$와 $V$의 텐서 크기 자체를 줄이는 기술이다.
기존 MHA는 $Q, K, V$가 각각 동일한 개수의 Head를 가지기 때문에, $K, V$를 모두 caching하려면 용량이 많이 필요하다.
MQA (Multi-Query Attention)
$Q$ Head는 기존처럼 여러 개를 유지하되, $K$와 $V$ Head는 딱 1개씩만 만들어서 모든 $Q$ Head가 이 1개의 $K, V$를 공유하도록 만든다.
Head의 개수를 $h$라고 할 때, KV Cache 용량이 기존 대비 $\frac{1}{h}$만큼 감소해서 속도와 메모리 효율은 높아진다.
하지만 모델의 생성 품질이 미세하게 떨어질 수 있다는 단점이 있다.
GQA (Grouped-Query Attention)
MHA와 MQA의 절충안으로, $Q$ Head들을 몇 개의 그룹으로 묶고 각 그룹당 1개의 $K, V$ Head를 공유하게 하는 방법이다.
MQA만큼은 아니지만 KV Cache 용량을 크게 줄이면서도, 기존 MHA와 거의 비슷한 수준의 모델 성능을 유지한다.